Justinian®
Die eigene Legal-AI-Engine hinter HAQQ Chat, eFirm und der Mobile App, gebaut für Juristen und für alle anderen.
Justinian klärt, was Sie tatsächlich fragen, welche Rechtsordnung gilt und was das Gesetz sagt, bevor ein einziges Wort entworfen wird. Gebaut für Arbeit, die geprüft, belegt und unterschrieben werden muss.
- Jede juristische Aussage
- BelegtJede juristische AussageAuf abgerufenem Recht gegründet. Wo die Rechtslage offen ist, weist Justinian darauf hin, statt sie für Sie zu entscheiden.
- Große Rechtsgebiete
- 24Große RechtsgebieteEntwurf, Prüfung, Recherche, grenzüberschreitende Analyse und Studium, eine Engine statt fünf Werkzeugen.
- Bester von 19 Modellen, unser eigener Benchmark
- 49 / 50Bester von 19 Modellen, unser eigener BenchmarkBestwert in unserem veröffentlichten modellübergreifenden Benchmark, einem Teil der 250 komplexen juristischen Aufgaben, an denen Justinian gemessen wird.
- Langstrecken-Aufgaben
- 1.372Langstrecken-AufgabenGanze Mandate von Anfang bis Ende, bewertet nach dem Alles-muss-bestehen-Prinzip: Teilpunkte zählen nicht.
Alles hinter einer einzelnen Antwort
Eine einzige Antwort läuft auf einem vollständigen Stack: Produktoberflächen, Sicherheit und Governance, Frontier-Modelle, belegte Daten und jurisdiktionsbewusstes Reasoning in MENA, Europa und den USA.
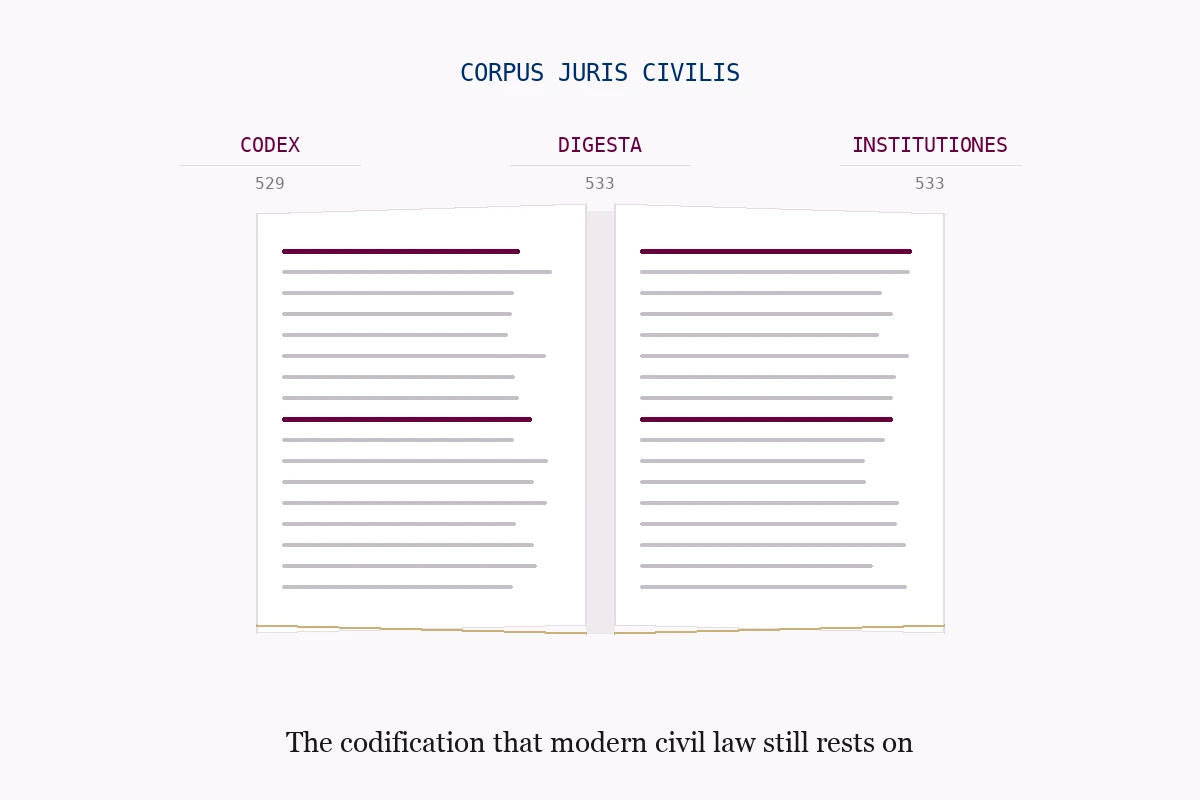
Warum Justinian?
Der Name Justinian ehrt Kaiser Justinian I. des Oströmischen Reiches, den Architekten der einflussreichsten Rechtskodifikation der Geschichte. Wo Kaiser Justinian das römische Recht für ein Reich vereinte, vereint unsere Justinian-Engine juristische Intelligenz für den Praktiker.
“Das Rechtssystem des Reiches bedurfte der Reparatur. Es gab drei Kodizes kaiserlicher Gesetze und andere Einzelgesetze, von denen viele widersprüchlich oder veraltet waren.”Über Kaiser Justinians Mandat, 527 n. Chr.
Ein Frontier-Modell ist eine Komponente, nicht das Produkt.
All das oben beschreibt, wie Justinian® funktioniert. Hier geht es darum, wofür. ChatGPT und Claude geben Ihnen Zugang zu einem LLM. HAQQ gibt Ihnen das Rechtssystem, das darauf aufgebaut ist, und das meiste, was eine juristische Antwort brauchbar macht, passiert außerhalb des Modells.
- Ein allgemeines Modell liefert die plausibelste Fortsetzung Ihres Prompts.
- Justinian® klärt die Rechtsfrage, die zuständige Jurisdiktion und die Sprache, in der das Recht verfasst ist, bevor überhaupt ein Modell aufgerufen wird.
- Ein allgemeines Modell antwortet aus dem, was es während des Trainings aufgenommen hat.
- Justinian® ruft die Gesetze, Rechtsprechung und Falldokumente ab, die tatsächlich zutreffen, und zitiert, was verwendet wurde.
- Ein allgemeines Modell ist das Produkt eines einzigen Anbieters, und Sie übernehmen dessen Entscheidungen.
- Justinian® leitet jede Art juristischer Arbeit an das jeweils passende Modell weiter, sodass der Wechsel zu einem besseren Modell eine reine Konfigurationsänderung ist.
Ein Frontier-Modell eines Drittanbieters führt weiterhin die eigentliche Generierung aus, und wir sagen das lieber offen, als anzudeuten, wir hätten unser eigenes trainiert. Die Orchestrierung, das Retrieval, die Jurisdiktionslogik, der Speicher und die Leitplanken darum herum stammen von uns, und genau diese Schicht trägt den juristischen Wert.
Die vollständige Begründung, mit beiden Pipelines im Bild.HAQQ within the Legal AI Landscape
Every category on the map, from general-purpose models to full-stack legal platforms.




Elf Kategorien, eine Karte. HAQQ steht allein in der Ecke für vollintegrierte, juristisch spezialisierte Systeme. Klicken Sie auf einen Knoten.
Einschränkungen
Trotz des Sprungs in den Fähigkeiten zeigt die Engine mehrere Einschränkungen, die bei juristischen Generierungsenginesüblich sind. Diese Grenzen zu verstehen ist essenziell für den verantwortungsvollen Einsatz.
Eingabeabhängigkeit
Unvollständige oder falsche Fakten führen zu unvollständiger oder falscher Analyse. Die Engine kann Tatsachenbehauptungen nicht unabhängig verifizieren.
- InNot connected
Wissensgrenzen
Kann nicht auf Informationen außerhalb der Trainingsdaten und verbundenen Quellenzugreifen. Echtzeit-Rechtsupdates erfordern explizite Integration mit Ihren Kanzleidaten.
Professionelle Überprüfung erforderlich
Jedes Ergebnis erfordert die Überprüfung durch einen qualifizierten Fachmann. Dies ist keine zu lösende Einschränkung, sondern ein Designprinzip.
Sicherheit und professionelle Verantwortung
Offenlegung
KI-erzeugte Inhalte sind immer gekennzeichnet, damit Sie stets wissen, was von der Engine stammt.
Kompetenz
Sie arbeitet in juristischen Domänen und verweigert Spekulation außerhalb davon.
Vertraulichkeit
Verschlüsselung während der Übertragung und im Ruhezustand, Isolation pro Organisation und kein Training mit Ihren Daten.
Aufsicht
Jede Ausgabe erfordert fachliche Prüfung, bevor sie zu Mandanten oder Gericht gelangt.
Die juristische Verantwortung liegt immer beim Anwalt. Das ist beabsichtigt.
Unsere Sicherheitspraxis lesenKI-Forschung hinter Justinian
Tiefgehende Einblicke in Architektur, Experimente und Benchmarks unserer Rechts-KI-Engine.
Vertraulichkeit ist die nächste Halluzination: KI und Mandantenvertraulichkeit für Anwälte
Erfundene KI-Zitate wurden von der Kuriosität zu Tausenden Fällen. Die Mandantenvertraulichkeit folgt derselben Kurve: die Auslöser, unsere Prognose und vier Maßnahmen.
Weiterlesen
Primärquellen entscheiden, ob Anwälte juristischer KI vertrauen: ein 10-Minuten-Test
Ein Zitat einer juristischen KI ist so viel wert wie der Text dahinter. Ein 10-Minuten-Test für jedes Tool und wo amtliche Gesetze in neun Golf- und MENA-Rechtsordnungen stehen.
Weiterlesen
So testen Sie eine Legal AI: 5 Fangfragen, 4 Frontier-Modelle
Wir baten vier Frontier-Modelle um Urteile zu einem Artikel, den es nicht gibt. Zwei lehnten ab. Zwei nannten zusammen 16. Hier sind die fünf Tests.
Weiterlesen
Schreiben Sie nicht mehr [MANDANT]: So anonymisieren Sie ein Dokument, bevor Sie es einer KI geben
Namen durch [MANDANT] zu ersetzen ist laut einer Studie vom September 2026 eine der beiden Anonymisierungsmethoden, die KI-Antworten am stärksten verschlechtern. Halten Sie Entitäten stattdessen getrennt und typisiert.
Weiterlesen
Wir haben neun KI-Systeme an einem libanesischen Waqf-Mandat getestet. Die meisten lagen beim entscheidenden Artikel falsch.
Eine echte arabische Mandantenanweisung, ein libanesisches Gesetz von 1947 und jede Fundstelle Artikel für Artikel geprüft. Justinian V2 erreichte 88. Das bestplatzierte Allzweckmodell 82.
Weiterlesen
Claude Opus 5.5 für juristische Arbeit: Wir haben unseren eigenen Benchmark gefahren und konnten keinen Sieger küren
Wir haben Opus 5.5, Opus 5 und Fable 5.1 zehn Prompts auf Anwaltsniveau und 120 Blindurteilen unterzogen. Vier Urteile trennen sie, im Kreis. Nur der Preis unterschied sie.
Weiterlesen
- Gemessen
Die häufigsten juristischen KI-Aufgaben
Die juristischen Aufgaben, die Anwältinnen und Anwälte am häufigsten an KI abgeben, nach Nutzungsanteil.
Daten ansehen - Gemessen
Modellübergreifender Rechts-Benchmark
Jedes getestete juristische KI-Modell, bewertet mit bis zu 50 Punkten über die Aufgabenkategorien hinweg.
Daten ansehen - Gemessen
Autonomiewerte nach Aufgabe
Wie eigenständig KI jede juristische Aufgabe übernehmen kann, und wo sie aufhören muss.
Daten ansehen - Gemessen
Aufgaben, die weiterhin einen Menschen brauchen
Der Anteil jeder juristischen Aufgabe, der laut Fachleuten weiterhin menschliches Urteil erfordert.
Daten ansehen - Gemessen
Zeitersparnis nach juristischer Aufgabe
Median der eingesparten Stunden pro Aufgabe, wenn mit KI statt allein gearbeitet wird.
Daten ansehen - Illustrativ
Risiko- und Halluzinationsraten
Geschätzte Fehlerraten über juristische Aufgaben hinweg, am höchsten bei Zitaten und Zuständigkeitsfragen.
Daten ansehen
Alle 25 Labs-Studien anzeigen
- Legal AI Request Clusters
- Prompt Type Distribution
- Work vs. Personal Use Cases
- Prompt Engineering Impact
- AI vs. Human Education Level
- Legal Productivity Benchmarks
- Legal AI Demand by Country
- Global Coverage Map
- Legal AI Market Growth
- Legal AI Investment & Funding
- Competitive Landscape Map
- AI Pricing & Monetization
- ROI & Cost Analysis
- Legal AI Adoption Timeline
- Legal AI Maturity Model
- Agentic AI in Law
- Workflow Automation Potential
- AI Spend & Budget Allocation
- Multi-Model Strategy in Legal
- Client Trust & Satisfaction
- Data Security & Compliance
- Workforce Impact & Role Change
- Future Outlook & Projections
- Legal AI Index
- Juristisches Ontologie-System
Häufig gestellte Fragen
Ist HAQQ nur ein GPT-Wrapper?
Nein. Ein Wrapper reicht Ihre Frage an ein öffentliches Modell weiter und gibt zurück, was dieses antwortet. Justinian®, die Engine hinter HAQQ, leitet Ihre Frage zuerst durch eine Orchestrierungsschicht, die uns gehört und die wir selbst betreiben. Sie trifft zehn Entscheidungen, bevor überhaupt ein Frontier-Modell aufgerufen wird: was Sie fragen, um welche Art juristischer Arbeit es geht, welche Rechtsordnung und Sprache betroffen sind, welche Werkzeuge genutzt und welche Sicherheitsprüfungen angewendet werden. Die endgültige Antwort schreibt dann ein Frontier-Modell eines Drittanbieters, doch Orchestrierung, Recherche, Gedächtnis, Werkzeuge und Sicherheit gehören uns. Ein Modellwechsel ist deshalb eine Konfigurationsänderung und kein Neubau. Unsere Benchmarks, einschließlich der Läufe, in denen ein anderes Modell besser abschneidet, sind in HAQQ Labs veröffentlicht.
Wie unterscheidet sich Justinian® von ChatGPT?
ChatGPT ist ein Allzweck-Sprachmodell, das plausibel klingenden Text erzeugt. Justinian® ist eine juristische KI-Engine: Bevor überhaupt ein allgemeines Modell aufgerufen wird, klärt sie, wonach Sie tatsächlich fragen, welche Jurisdiktion einschlägig ist, in welcher Sprache das maßgebliche Recht verfasst ist und was die Anfrage erfordert. Erst danach läuft das allgemeine Modell, und zwar auf einer bereits aufbereiteten Fragestellung. Justinian wendet Rechtsnormen auf Sachverhalte an, wahrt die Grenzen der jeweiligen Jurisdiktion, belegt Aussagen mit den abgerufenen Quellen und liefert strukturierte, mandantenfertige Arbeitsergebnisse.
Zitiert Justinian® echte Rechtsprechung?
Ja. Justinian® durchsucht verifizierte juristische Datenbanken, bevor er antwortet. Jedes Zitat ist rückverfolgbar und überprüfbar.
Kann Justinian® Verträge auf Arabisch verfassen?
Ja. Justinian® verfasst nativ auf Arabisch, Englisch und Französisch mit vollständiger RTL-Unterstützung.
Welche Jurisdiktionen unterstützt Justinian®?
Justinian® führt juristische Analysen für die MENA-Region, Europa und die USA sowie für internationale Schiedsordnungen einschließlich ICC und UNCITRAL durch und verfasst Dokumente auf Englisch, Arabisch und Französisch. Die Tiefe der Abdeckung unterscheidet sich je nach Jurisdiktion, denn sie hängt davon ab, wie gut die Rechtsquellen digitalisiert und wie weit sie öffentlich zugänglich sind. Statt eine pauschale Gesamtzahl zu nennen, beantworten wir die Frage lieber konkret für die Jurisdiktion, in der Sie tätig sind.
Ist das Reasoning von Justinian® prüfbar?
Ja. Jede Justinian®-Ausgabe enthält eine transparente Begründungskette.
Was geschieht, bevor Justinian® eine Frage beantwortet?
Ihre Frage gelangt nicht unmittelbar an ein Allzweck-Modell. Sie durchläuft zunächst eine Verarbeitungsstufe, die wir selbst entwickelt haben und kontrollieren. Diese Stufe klärt, wonach Sie tatsächlich fragen, um welche Art juristischer Arbeit es sich handelt, welche Jurisdiktion betroffen ist und in welcher Sprache das maßgebliche Recht verfasst ist, und sie erfasst die Sachverhaltsangaben Ihrer Anfrage als strukturierte Daten. Erst danach läuft das allgemeine Modell, und es erhält die Fragestellung bereits aufbereitet, statt sie erraten zu müssen.
Warum wird die Antwort besser, wenn vor dem Modellaufruf Arbeit geleistet wird?
Dafür gibt es zwei Gründe. Erstens ist das Kontextfenster eines Modells begrenzt: Alles, was unnötig geladen wird, konkurriert mit Ihrem eigentlichen Dokument um Aufmerksamkeit. Zweitens verwendet ein Modell, dem strukturierte Sachverhaltsdaten statt einer Textwand übergeben werden, sein Budget auf juristisches Reasoning und nicht auf das Entschlüsseln des Eingangsmaterials. Der zweite Effekt fällt deutlich stärker aus, als die meisten erwarten, und genau deshalb liefert dasselbe Allzweck-Modell innerhalb von Justinian® bessere juristische Arbeit als in einem einfachen Wrapper.
Welches KI-Modell verwendet Justinian®, und sind Sie an einen einzigen Anbieter gebunden?
Wir setzen bewusst nicht auf einen einzigen Anbieter. Die abschließende Generierung übernimmt ein Frontier-Modell eines Drittanbieters, doch alle Schichten, die unsere Wertschöpfung tragen, funktionieren unabhängig von einem bestimmten Modell: Orchestrierung, Werkzeuge, Retrieval, Gedächtnis und Sicherheitsmechanismen. Justinian® ist so konzipiert, dass unterschiedliche Arten juristischer Arbeit an unterschiedliche Modelle geleitet werden. Erscheint ein besseres oder günstigeres Modell, ist dessen Einsatz daher eine Frage der Konfiguration und kein Neubau.
Kann Justinian® gescannte Dokumente und Fotografien lesen?
Ja. Wir behandeln die Dokumentenerfassung als eigenständige technische Kernaufgabe und nicht als nebensächlichen Vorverarbeitungsschritt, denn ein großer Teil juristischer Arbeit erreicht uns als Scan, als Foto einer gestempelten Seite oder als PDF, das ausgedruckt und schief erneut eingescannt wurde. Ein Fehler, der auf dieser Stufe entsteht, lässt sich später nicht mehr beheben: Das System würde dann einwandfrei über die falsche Klauselnummer argumentieren.
Erinnert sich Justinian® an meine früheren Mandate?
Ja. Justinian® hält die Zusammenhänge zwischen Ihren Mandaten über die Zeit hinweg fest und greift darauf zurück, wenn eine Frage es erfordert, statt lediglich die letzten Nachrichten erneut in den Prompt zu schreiben. Genau dadurch erkennt das System, dass die Gegenpartei eines Vertrags, den Sie heute prüfen, dieselbe ist wie in einem Streitfall vor zwei Monaten.
Halluziniert Justinian®?
Jedes System, das auf einem Sprachmodell aufsetzt, kann eine falsche Antwort erzeugen, und jeder Anbieter, der etwas anderes behauptet, geht nicht sorgfältig mit Worten um. Eine gute Architektur macht Fehler seltener und erkennbar: Juristische Aussagen werden auf Grundlage abgerufener Quellen erzeugt, jede Aussage trägt eine Fundstelle, die Sie öffnen können, und wo Quellen sich widersprechen oder die Rechtslage tatsächlich unklar ist, weist Justinian® auf die Unsicherheit hin, statt sie für Sie aufzulösen. Das System ist darauf ausgelegt, von einem qualifizierten Juristen geprüft zu werden, und nicht darauf, ihn zu ersetzen.
Woran erkenne ich, ob ein Rechts-KI-Produkt nur ein ChatGPT-Wrapper ist?
Vier Fragen in einer Demo, und sie funktionieren bei jedem Anbieter, uns eingeschlossen. Erstens: Fragen Sie etwas außerhalb des Rechts. Ein verpacktes Allzweck-Modell beantwortet in der Regel auch eine medizinische Frage. Zweitens: Stellen Sie dieselbe juristische Frage in zwei Sprachen. Ändert sich die Substanz der Antwort, wird die Sprache erst nach dem Reasoning behandelt und nicht davor. Drittens: Laden Sie ein schlecht fotografiertes Dokument hoch. Und viertens: Führen Sie das System in einen ungeklärten Rechtsbereich. Ein für die anwaltliche Praxis gebautes System sagt Ihnen dort, dass die Rechtslage unsicher ist, statt eine selbstbewusste Antwort zu liefern.
Wie wird Justinian® evaluiert?
An rechtsspezifischen Benchmarks, nicht an allgemeinen, denn ein Modell mit guten Werten im allgemeinen Schlussfolgern kann an einer Klausel trotzdem scheitern. Validierung auf Klauselebene, jurisdiktionelle Genauigkeit und fortlaufendes Feedback praktizierender Anwältinnen und Anwälte bestimmen, was die Engine vor und um jeden Modellaufruf herum tut. Wir veröffentlichen die Ergebnisse, statt sie zu beschreiben, auch jene, in denen ein Frontier-Modell besser abschneidet.
Woher weiß ich, dass eine Zahl auf dieser Seite echt ist?
Jede Zahl, die wir veröffentlichen, sagt, woher wir sie kennen. Gemessen heißt: aus unseren Nutzungsdaten oder unserem eigenen Benchmark-Lauf. Zitiert heißt: ein Ergebnis Dritter, mit Quelle verlinkt. Illustrativ heißt: ein Richtungsszenario, und es trägt einen entsprechenden Hinweis, auch bei den Beispielen weiter oben. Sagt eine Zahl nicht, welches der drei sie ist, behandeln Sie das als Fehler und sagen Sie uns Bescheid.
Veröffentlichen Sie auch Ergebnisse, bei denen ein anderes Modell gewinnt?
Ja, und Sie sollten jedem Legal-AI-Anbieter misstrauen, der das nicht tut. Ein Benchmark, den sein Urheber immer gewinnt, ist Marketing, keine Evaluation. Unsere veröffentlichten Läufe enthalten Aufgaben und Kategorien, in denen ein Frontier-Modell besser abschneidet, denn wer kauft, muss wissen, wo das Werkzeug stark ist und wo nicht, bevor er sich vor einem Mandanten darauf verlässt.