Justinian यह स्थापित करता है कि आप वास्तव में क्या पूछ रहे हैं, कौन सा क्षेत्राधिकार इसे नियंत्रित करता है, और कानून क्या कहता है, इससे पहले कि एक भी शब्द का मसौदा तैयार किया जाए। ऐसे काम के लिए बनाया गया है जिसकी समीक्षा, उद्धरण और हस्ताक्षर किए जाने हैं।
- प्रत्येक कानूनी दावा
- उद्धृतप्रत्येक कानूनी दावापुनः प्राप्त कानून पर आधारित। जहां कानून अनिश्चित है, Justinian इसे आपके लिए हल करने के बजाय इसे चिह्नित करता है।
- प्रमुख अभ्यास क्षेत्र
- 24प्रमुख अभ्यास क्षेत्रमसौदा तैयार करना, समीक्षा करना, अनुसंधान करना, सीमा पार विश्लेषण और अध्ययन करना - एक इंजन, पाँच उपकरण नहीं।
- 19 मॉडलों का उच्चतम स्कोर
- 49 / 5019 मॉडलों का उच्चतम स्कोरहमारे प्रकाशित बेंचमार्क पर 250 जटिल कानूनी कार्यों में।
- दीर्घकालिक कार्य
- 1,372दीर्घकालिक कार्यपूरे मामले शुरू से अंत तक चलाए जाते हैं और सभी पास के रूप में वर्गीकृत किए जाते हैं: हर कदम को पास होना चाहिए, आंशिक क्रेडिट मायने नहीं रखता।
एक ही उत्तर के पीछे सब कुछ
एक उत्तर एक पूर्ण स्टैक पर चलता है: उत्पाद सतहें, सुरक्षा और शासन, अत्याधुनिक मॉडल, जमीनी डेटा, और MENA, यूरोप और अमेरिका में न्यायक्षेत्र-जागरूक तर्क।
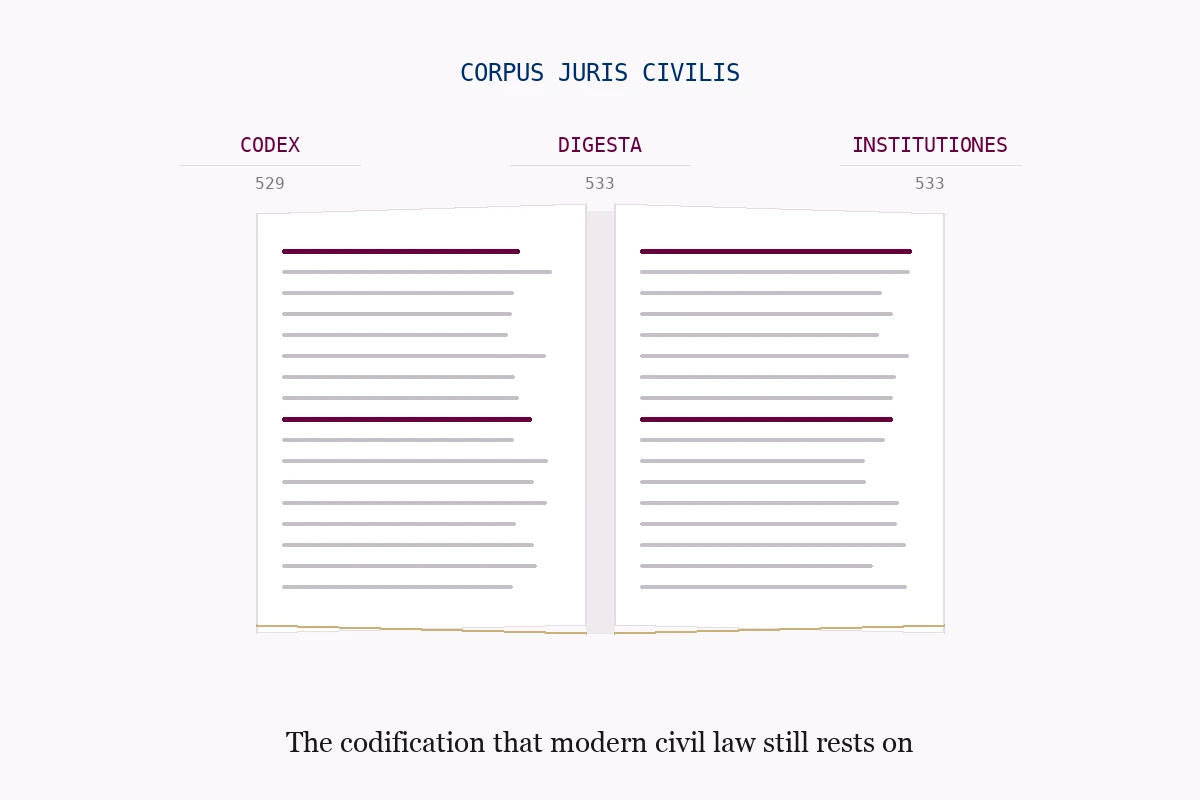
जस्टिनियन क्यों?
नाम जस्टिनियन सम्मानित करता है सम्राट जस्टिनियन I पूर्वी रोमन साम्राज्य का - इतिहास के सबसे प्रभावशाली कानूनी संहिताकरण का वास्तुकार। जहां सम्राट Justinian ने एक साम्राज्य के लिए रोमन कानून को एकीकृत किया, वहीं हमारा Justinian इंजन व्यवसायी के लिए कानूनी बुद्धिमत्ता को एकीकृत करता है।
“साम्राज्य की कानूनी प्रणाली को मरम्मत की आवश्यकता थी। शाही कानूनों की तीन संहिताएं और अन्य व्यक्तिगत कानून मौजूद थे, जिनमें से कई विरोधाभासी थे या पुराने हो गए थे।”- सम्राट Justinian के जनादेश पर, 527 ईस्वी
HAQQ within the Legal AI Landscape
Every category on the map, from general-purpose models to full-stack legal platforms.




ग्यारह श्रेणियां, एक मानचित्र। HAQQ पूर्ण-स्टैक, कानूनी-विशेषज्ञता वाले क्षेत्र में एकमात्र है। किसी भी नोड पर क्लिक करके विवरण देखें।
सीमाएँ
क्षमताओं में छलांग के बावजूद, इंजन कई सामान्य सीमाओं को प्रदर्शित करता है जो इसमें आम हैं कानूनी जनरेशन इंजन. इन सीमाओं को समझना जिम्मेदार उपयोग के लिए आवश्यक है।
इनपुट निर्भरता
अधूरी या गलत जानकारी से अधूरा या गलत विश्लेषण होता है। इंजन तथ्यात्मक दावों को स्वतंत्र रूप से सत्यापित नहीं कर सकता है - गुणवत्ता इनपुट से ही गुणवत्ता आउटपुट निर्धारित होता है।
- InNot connected
ज्ञान सीमाएँ
प्रशिक्षण डेटा और जुड़े स्रोतोंके बाहर की जानकारी तक पहुंच नहीं बना सकता है। वास्तविक समय के कानूनी अपडेट के लिए आपकी फर्म के डेटा के साथ स्पष्ट एकीकरण की आवश्यकता होती है।
पेशेवर समीक्षा आवश्यक
प्रत्येक आउटपुट के लिए एक योग्य पेशेवर द्वारा समीक्षा की आवश्यकता होती है। यह हल की जाने वाली कोई सीमा नहीं है बल्कि एक डिज़ाइन सिद्धांत।
सुरक्षा और व्यावसायिक जिम्मेदारी
खुलासा
AI-जनरेटेड सामग्री को हमेशा लेबल किया जाता है, इसलिए आपको हमेशा पता रहता है कि इंजन से क्या आया है।
क्षमता
यह कानूनी डोमेन के भीतर काम करता है और उनके बाहर अनुमान लगाने से मना करता है।
गोपनीयता
शून्य डेटा प्रतिधारण, एंड-टू-एंड एन्क्रिप्शन, और आपके डेटा पर कोई प्रशिक्षण नहीं।
पर्यवेक्षण
ग्राहक या अदालत तक पहुँचने से पहले हर आउटपुट को पेशेवर समीक्षा की आवश्यकता होती है।
कानूनी जिम्मेदारी हमेशा वकील के पास रहती है। यह जानबूझकर किया गया है।
हमारी सुरक्षा प्रथाएँ पढ़ेंजस्टिनियन के पीछे AI अनुसंधान
हमारे लीगल AI इंजन को शक्ति देने वाले आर्किटेक्चर, प्रयोगों और बेंचमार्क में गहराई से गोता लगाएँ।
- मापा गया
AI उपयोग के आधार पर शीर्ष कानूनी कार्य
कानूनी कार्य जो वकील अक्सर AI को सौंपते हैं, उपयोग के हिस्से के अनुसार रैंक किए गए।
डेटा देखें - मापा गया
क्रॉस-मॉडल कानूनी बेंचमार्क
हमारे द्वारा परीक्षण किए गए प्रत्येक कानूनी AI मॉडल को कानूनी कार्य श्रेणियों में से 50 में से स्कोर किया गया।
डेटा देखें - मापा गया
कार्य के अनुसार AI स्वायत्तता स्कोर
AI प्रत्येक कानूनी कार्य को कितनी स्वायत्तता से संभाल सकता है, और उसे कहाँ रुकना चाहिए।
डेटा देखें - मापा गया
वे कार्य जिनमें अभी भी मानव की आवश्यकता है
प्रत्येक कानूनी कार्य का वह हिस्सा जिसके लिए पेशेवरों का कहना है कि अभी भी मानवीय निर्णय की आवश्यकता है।
डेटा देखें - मापा गया
कानूनी कार्य के अनुसार समय की बचत
जब कोई वकील अकेले काम करने के बजाय AI के साथ काम करता है तो प्रति कार्य बचाए गए औसत घंटे।
डेटा देखें - उदाहरणार्थ
जोखिम और भ्रम की दरें
कानूनी कार्यों में अनुमानित त्रुटि दरें, उद्धरण और क्षेत्राधिकार के काम के लिए सबसे अधिक।
डेटा देखें
अक्सर पूछे जाने वाले प्रश्न
Justinian® ChatGPT से कैसे अलग है?
ChatGPT एक सामान्य-उद्देश्य वाला भाषा मॉडल है जो प्रशंसनीय लगने वाले टेक्स्ट को उत्पन्न करता है। Justinian® एक लीगल AI इंजन है: किसी भी सामान्य मॉडल को कॉल करने से पहले, यह स्थापित करता है कि आप वास्तव में क्या पूछ रहे हैं, कौन सा अधिकार क्षेत्र लागू होता है, शासी कानून किस भाषा में है, और अनुरोध की क्या आवश्यकता है। सामान्य मॉडल फिर एक ऐसे प्रश्न पर चलता है जिसे पहले ही तैयार किया जा चुका है। यह तथ्यों पर कानूनी नियमों को लागू करता है, अधिकार क्षेत्र की सीमाओं का सम्मान करता है, पुनर्प्राप्त स्रोतों का हवाला देता है, और संरचित, ग्राहक-तैयार डिलिवरेबल्स का उत्पादन करता है।
क्या Justinian® वास्तविक केस कानून का हवाला देता है?
हाँ। Justinian® उत्तर देने से पहले सत्यापित कानूनी डेटाबेस और आधिकारिक स्रोतों की खोज करता है। प्रत्येक उद्धरण का पता लगाया जा सकता है और सत्यापित किया जा सकता है। जब स्रोत संघर्ष करते हैं या कानून अस्पष्ट होता है, तो Justinian एक आत्मविश्वासी लेकिन गलत उत्तर प्रस्तुत करने के बजाय अनिश्चितता को चिह्नित करता है।
क्या Justinian® अरबी में अनुबंधों का मसौदा तैयार कर सकता है?
हाँ। Justinian® अरबी, अंग्रेजी, फ्रेंच और अन्य भाषाओं में पूर्ण RTL समर्थन के साथ मूल रूप से ड्राफ्ट करता है। यह प्रत्येक भाषा में कानूनी बारीकियों को समझता है और दोनों संस्करणों में कानूनी सटीकता बनाए रखते हुए द्विभाषी अनुबंध तैयार कर सकता है।
Justinian® किन न्यायक्षेत्रों का समर्थन करता है?
Justinian® MENA, यूरोप, अमेरिका और ICC और UNCITRAL सहित अंतरराष्ट्रीय मध्यस्थता फ्रेमवर्क पर तर्क करता है, और यह अंग्रेजी, अरबी और फ्रेंच में ड्राफ्ट करता है। न्यायक्षेत्र के अनुसार गहराई भिन्न होती है, क्योंकि यह इस बात पर निर्भर करता है कि स्रोत कानून कितना अच्छी तरह से डिजिटाइज़ किया गया है और इसका कितना हिस्सा सार्वजनिक है। एक एकल वैश्विक संख्या उद्धृत करने के बजाय, हम उस विशिष्ट न्यायक्षेत्र के लिए प्रश्न का उत्तर देना चाहेंगे जिसमें आप काम करते हैं।
क्या Justinian® का तर्क लेखापरीक्षण योग्य है?
हाँ। प्रत्येक Justinian® आउटपुट में एक पारदर्शी तर्क श्रृंखला शामिल होती है - आप देख सकते हैं कि कौन से नियम लागू किए गए थे, किन स्रोतों से परामर्श किया गया था, और निष्कर्ष तक कैसे पहुंचा गया था। यह लेखापरीक्षण योग्यता पेशेवर जवाबदेही और ग्राहक विश्वास के लिए महत्वपूर्ण है।
जस्टिनियन किसी प्रश्न का उत्तर देने से पहले क्या होता है?
आपका प्रश्न सीधे किसी सामान्य-उद्देश्य वाले मॉडल पर नहीं जाता है। यह पहले एक ऐसे चरण से गुजरता है जिसे हम नियंत्रित करते हैं, जो यह निर्धारित करता है कि आप वास्तव में क्या पूछ रहे हैं, यह किस प्रकार का कानूनी कार्य है, कौन सा क्षेत्राधिकार लागू है, शासी कानून किस भाषा में लिखा गया है, और आपके अनुरोध के अंदर के तथ्य संरचित डेटा के रूप में। तभी सामान्य मॉडल चलता है, और यह प्रश्न को पहले से ही तैयार करके आता है, बजाय इसके कि वह अनुमान लगाए।
मॉडल कॉल से पहले काम करने से उत्तर बेहतर क्यों बनता है?
दो कारण। एक मॉडल की संदर्भ विंडो सीमित होती है, इसलिए अनावश्यक रूप से लोड किया गया कुछ भी आपके वास्तविक दस्तावेज़ के साथ ध्यान के लिए प्रतिस्पर्धा करता है। और एक मॉडल जिसे गद्य की दीवार के बजाय संरचित तथ्य दिए जाते हैं, वह अपने बजट को कानूनी तर्क पर खर्च करता है, बजाय इसके कि उसे क्या दिया गया था। दूसरा प्रभाव अधिकांश लोगों की अपेक्षा से बड़ा है, और यही कारण है कि वही सामान्य-उद्देश्य वाला मॉडल जस्टिनियन के अंदर एक साधारण रैपर के अंदर की तुलना में बेहतर कानूनी कार्य करता है।
Justinian® किस AI मॉडल का उपयोग करता है, और क्या आप एक विक्रेता से बंधे हैं?
हम जानबूझकर किसी एक विक्रेता पर निर्भर नहीं करते हैं। एक तृतीय-पक्ष फ्रंटियर मॉडल अंतिम जनरेशन करता है, लेकिन हमारी मूल्यवान हर परत किसी विशेष मॉडल से स्वतंत्र रूप से चलती है: ऑर्केस्ट्रेशन, टूलिंग, रिट्रीवल, मेमोरी और सुरक्षा। Justinian® को विभिन्न प्रकार के कानूनी कार्यों को विभिन्न मॉडलों तक पहुंचाने के लिए डिज़ाइन किया गया है, इसलिए यदि कोई बेहतर या सस्ता मॉडल आता है, तो उसे अपनाना एक पुनर्निर्माण के बजाय एक कॉन्फ़िगरेशन परिवर्तन है।
क्या Justinian® स्कैन किए गए दस्तावेज़ और तस्वीरें पढ़ सकता है?
हाँ। हम दस्तावेज़ सेवन को एक प्रथम-श्रेणी की इंजीनियरिंग समस्या मानते हैं, न कि एक प्रीप्रोसेसिंग के बाद का विचार, क्योंकि कानूनी काम का एक बड़ा हिस्सा स्कैन, मुहर लगी पृष्ठ की तस्वीर, या एक PDF के रूप में आता है जिसे मुद्रित और फिर से तिरछा स्कैन किया गया था। उस चरण में शुरू की गई त्रुटि को बाद में ठीक नहीं किया जा सकता है: सिस्टम गलत खंड संख्या के बारे में त्रुटिहीन तर्क करेगा।
क्या Justinian® मेरे पिछले मामलों को याद रखता है?
हाँ। Justinian® समय के साथ आपके मामलों के बीच संबंधों को रखता है और जब कोई प्रश्न इसकी मांग करता है तो उन पर आधारित होता है, बजाय इसके कि केवल हाल के संदेशों को प्रॉम्प्ट में फिर से चलाए। यही वह है जो इसे यह पहचानने देता है कि जिस अनुबंध की आप आज समीक्षा कर रहे हैं उसमें प्रतिपक्षी वही है जो दो महीने पहले के विवाद से था।
क्या Justinian® मतिभ्रम करता है?
भाषा मॉडल पर निर्मित कोई भी सिस्टम गलत उत्तर दे सकता है, और कोई भी विक्रेता जो आपको अन्यथा बताता है वह शब्दों के प्रति सावधान नहीं है। एक अच्छी वास्तुकला क्या करती है वह गलतियों को दुर्लभ और पता लगाने योग्य बनाती है: कानूनी दावे पुनः प्राप्त स्रोतों के खिलाफ उत्पन्न होते हैं, हर दावे में एक उद्धरण होता है जिसे आप खोल सकते हैं, और जहां स्रोत विरोधाभासी होते हैं या कानून वास्तव में अस्पष्ट होता है Justinian® आपके लिए इसे हल करने के बजाय अनिश्चितता को इंगित करता है। इसे किसी पेशेवर द्वारा समीक्षा करने के लिए बनाया गया है, न कि उसे बदलने के लिए।
मैं कैसे बताऊँ कि कोई कानूनी AI उत्पाद सिर्फ एक ChatGPT रैपर है?
एक डेमो में चार प्रश्न, और वे हम सहित किसी भी विक्रेता पर काम करते हैं। उससे कानून के बाहर कुछ पूछें: एक रैप किया गया सामान्य मॉडल आमतौर पर एक चिकित्सा प्रश्न का उत्तर देगा। एक ही कानूनी प्रश्न को दो भाषाओं में पूछें: यदि पदार्थ बदलता है, तो भाषा को तर्क के बाद संभाला जाता है न कि उससे पहले। एक खराब फोटोग्राफ किया गया दस्तावेज़ अपलोड करें। और इसे कानून के एक अनसुलझे क्षेत्र की ओर धकेलें, जहां पेशेवर काम के लिए बनाया गया एक सिस्टम आपको बताएगा कि जमीन अनिश्चित है बजाय इसके कि एक आत्मविश्वासपूर्ण उत्तर दे।
जस्टिनियन का मूल्यांकन कैसे किया जाता है?
सामान्य बेंचमार्क के बजाय कानूनी-विशिष्ट बेंचमार्क के खिलाफ, क्योंकि एक मॉडल जो सामान्य तर्क पर अच्छा स्कोर करता है, वह अभी भी किसी खंड पर बेकार हो सकता है। खंड-स्तरीय सत्यापन, क्षेत्रीय सटीकता और अभ्यास करने वाले वकीलों से निरंतर प्रतिक्रिया इंजन को हर मॉडल कॉल से पहले और उसके आसपास क्या करता है, यह चलाती है: क्या पुनर्प्राप्त किया जाता है, कौन सी क्षमताएं चलती हैं, और मानव समीक्षा के लिए क्या ध्वजांकित किया जाता है। परिणाम वर्णित होने के बजाय प्रकाशित किए जाते हैं, जिनमें वे भी शामिल हैं जहां एक फ्रंटियर मॉडल हमें हराता है।
मुझे कैसे पता चलेगा कि इस पृष्ठ पर कोई संख्या वास्तविक है?
हम जो भी आंकड़ा प्रकाशित करते हैं, वह बताता है कि हम इसे कैसे जानते हैं। 'मापा गया' का अर्थ है कि यह हमारे अपने उपयोग डेटा या हमारे अपने बेंचमार्क रन से आता है। 'उद्धृत' का अर्थ है कि यह एक तीसरे पक्ष की खोज है, जो इसके स्रोत से जुड़ी है। 'उदाहरण' का अर्थ है कि यह एक दिशात्मक परिदृश्य है, और इसमें ऐसा कहने वाला एक बैज होता है, जिसमें इस पृष्ठ पर आगे दिए गए कार्य उदाहरण भी शामिल हैं। यदि कोई संख्या यह नहीं बताती है कि यह तीनों में से कौन सा है, तो इसे एक दोष मानें और हमें बताएं।
क्या आप ऐसे परिणाम प्रकाशित करते हैं जहाँ कोई अन्य मॉडल जीतता है?
हाँ, और आपको किसी भी कानूनी AI विक्रेता पर संदेह होना चाहिए जो ऐसा नहीं करता है। एक बेंचमार्क जिसे उसका लेखक हमेशा जीतता है, वह मार्केटिंग है, मूल्यांकन नहीं। हमारे प्रकाशित रनों में ऐसे कार्य और श्रेणियां शामिल हैं जहाँ एक फ्रंटियर मॉडल हमसे ऊपर स्कोर करता है, क्योंकि एक खरीदार को यह जानने की आवश्यकता होती है कि उपकरण कहाँ मजबूत है और कहाँ नहीं, इससे पहले कि वे ग्राहक के सामने उस पर भरोसा करें।