In breve: abbiamo speso meno di $0,20 per testare se un modello che non genera testo dovesse rientrare nel nostro stack di Legal AI. Lo fa, in tre punti, ed è in produzione in uno di essi. Ha fallito in altri tre, e uno di questi fallimenti si è invertito così completamente che le risposte contenenti citazioni inventate hanno ottenuto punteggi più alti di quelle oneste. La regola che ne è derivata è la parte utile: questa classe di modelli è forte dove un giudizio ha una risposta oggettiva che le prove fornite risolvono, e debole ovunque il giudizio sia una questione di gusto.
La proposta e il motivo per cui l'abbiamo presa sul serio
Circola un'argomentazione secondo cui la maggior parte degli agenti AI spreca la risorsa più costosa in decisioni che non hanno mai avuto bisogno di una frase. Instradare una richiesta al modello giusto è una decisione. Decidere se una chiamata a uno strumento è sicura è una decisione. Classificare cinquanta documenti recuperati sono cinquanta decisioni. Nessuna di queste produce prosa che qualcuno legga, eppure tutte sono affidate a un modello che fattura a parole e risponde a paragrafi.
Nel settembre 2026 TypeSafe AI ha rilasciato un modello costruito attorno a quell'argomento. Jev è ciò che chiamano un modello di Sistema Uno, e la proprietà distintiva è che non genera alcun testo. Si INVIA un blocco di stato più un insieme di domande tipizzate, e si ottengono probabilità calibrate, tutte valutate in un unico viaggio di andata e ritorno parallelo.
Ci sono tre primitive e non ce n'è una quarta. Un noul è una domanda sì o no che restituisce una probabilità tra 0 e 1, e quella probabilità è la confidenza: 0.5 significa un lancio di moneta, non un'intensità media. Una choice sceglie un'opzione da un elenco che si definisce, e fisicamente non può restituire un'opzione non dichiarata. Uno score posiziona l'input su una scala ordinata descritta a parole, e restituisce la media ponderata per la probabilità, quindi una divisione 70/30 su due livelli torna come 1.30 piuttosto che 1 o 2.
Questa è l'intera superficie. Non può riassumere, riscrivere, redigere, estrarre un intervallo o cercare nulla. Non ha una base di conoscenza e nessun recupero. Risponde a domande il cui spazio di risposta è stato dichiarato, su uno stato che gli è stato fornito.
La parte facile da perdere
L'istinto è di archiviarlo come un classificatore economico e veloce. Questo sottovaluta ciò che è realmente cambiato, che non è il prezzo ma l'ordine.
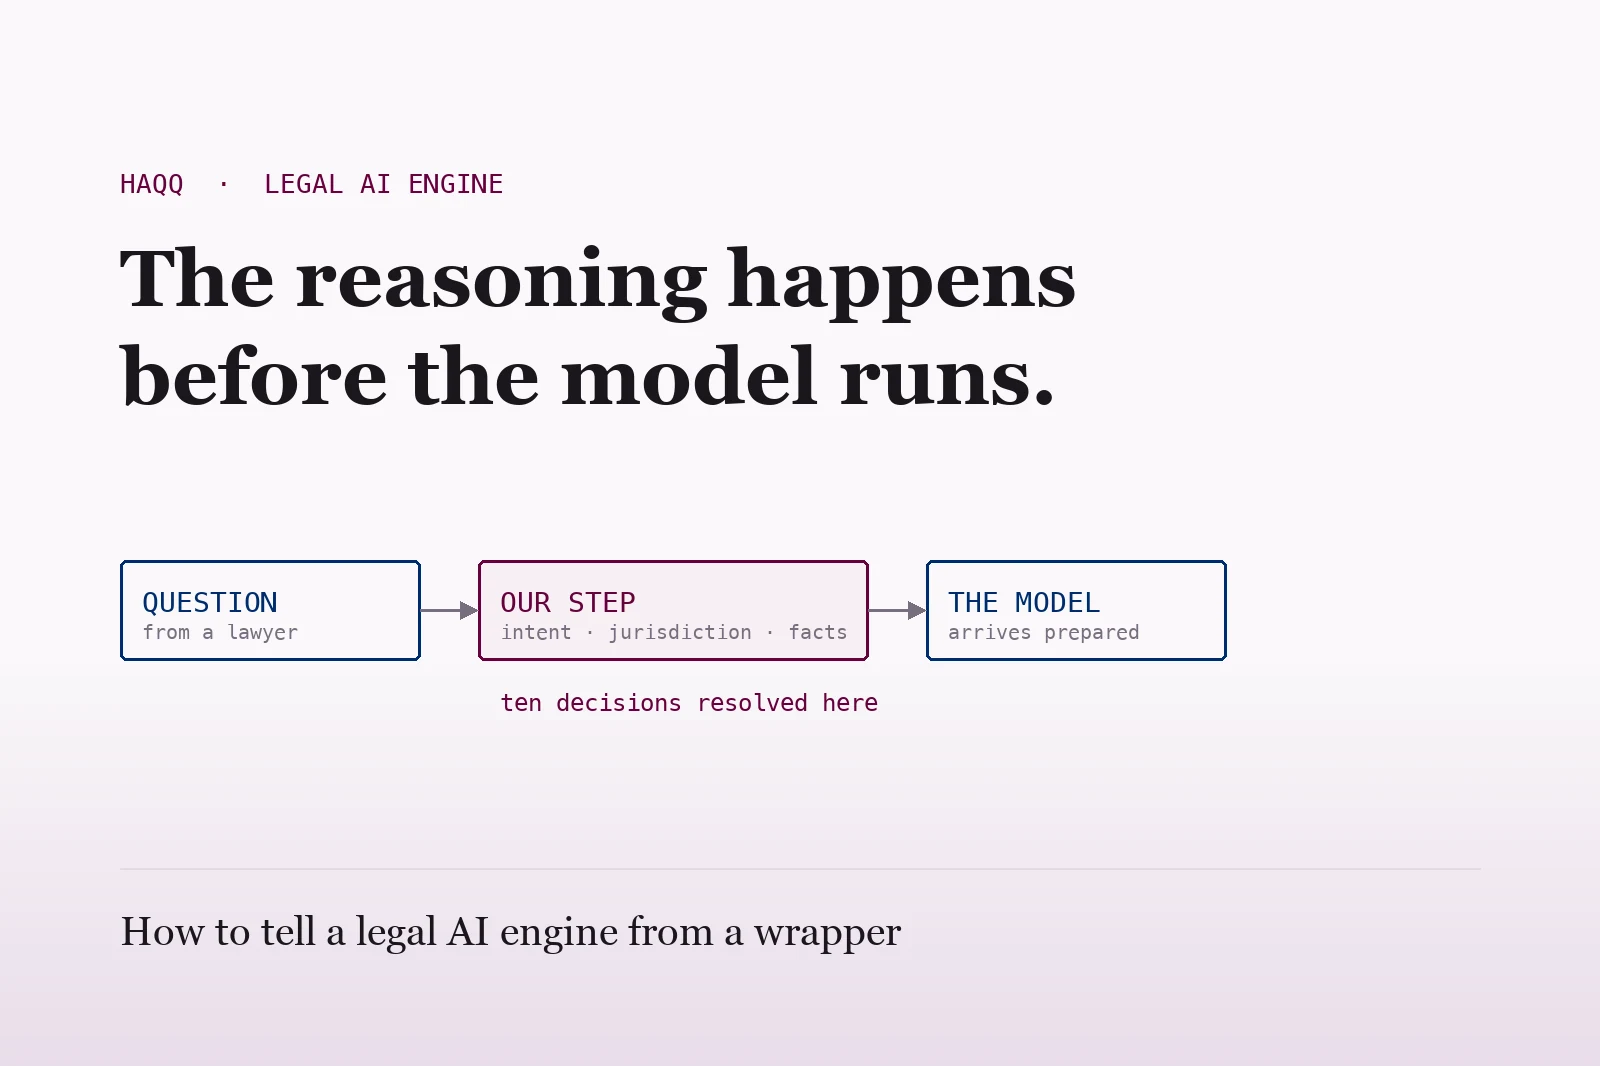
Un modello linguistico scrive un token alla volta, quindi il token nove non può esistere finché non esiste il token otto. Chiedetegli quattro domande non correlate su un contratto e quei quattro giudizi indipendenti si mettono in coda l'uno dietro l'altro, tornano come un blob che poi si analizza, si convalida e si ritenta quando la forma è sbagliata. Jev elimina la coda. Si dichiara lo spazio di risposta in anticipo e ogni domanda si risolve contemporaneamente rispetto allo stesso stato. Il testo è una linea che si deve percorrere. Uno spazio di risposta è una stanza che si vede tutta in una volta.
| Modello linguistico di frontiera | Jev | |
|---|---|---|
| Output | Una stringa che si analizza e convalida | Un valore tipizzato su cui il codice si ramifica |
| Ordine | Sequenziale, ogni token condizionato all'ultimo | Nessuno, tutte le domande in parallelo |
| Incertezza | Nascosta in una prosa fiduciosa | Una probabilità esplicita su ogni opzione |
| Modalità di fallimento | Forma malformata, opzione inventata, rifiuto | Una risposta errata valida per lo schema |
| Può scrivere? | Sì, è il prodotto | No. Né una frase, né un intervallo, né codice |
| Può cercare cose? | Con gli strumenti, sì | Mai. Nessun recupero, nessuna base di conoscenza |
Quella riga di modalità di errore è quella che conta nel diritto, e vale la pena essere diretti al riguardo. La garanzia offerta è che non otterrai mai un valore al di fuori del tuo schema. Non è una garanzia che il valore sia corretto.
Un errore valido per lo schema rimborsa il cliente sbagliato con la stessa velocità con cui lo fa uno malformato.
Per un'azienda di Legal AI, la parola interessante in tutto questo è calibrato. Un numero su cui puoi creare un ramo nel codice è un oggetto diverso da un paragrafo che un avvocato deve leggere e di cui deve fidarsi. Abbiamo scritto nel nostro post sul livello di orchestrazione di Legal AI che la parte dell'AI legale che determina se le citazioni reggono è invisibile dall'esterno. Questo è un candidato per riempire parte di quella parte invisibile.
Quindi l'abbiamo eseguito su tutto il nostro stack. Ogni misurazione qui sotto è nostra, sul nostro corpus, e anche quelle che sono andate male sono qui.
Cosa abbiamo misurato e quanto è costato
Dieci superfici, tredici ticket chiusi, meno di 0,20 $ di spesa totale. Non è un vanto di frugalità. È il motivo per cui l'esperimento valeva la pena di essere eseguito: a una frazione di centesimo per giudizio puoi permetterti di controllare ogni evento anziché campionare, e un risultato nullo costa quasi nulla da stabilire.
Latenza, misurata sul nostro traffico con una connessione "warm" tenuta aperta: 292ms in mediana, 374ms al p90, 395ms al p95, su 40 chiamate. Solo il calcolo lato server è di 112ms. La nostra prima misurazione diceva 700ms, e abbiamo ripetuto quel numero internamente per una settimana prima di notare che era sbagliato. Non avevamo mai riutilizzato una connessione, quindi ogni chiamata pagava per un nuovo handshake. Stessa API, stessa versione del modello, una misurazione attenta della cosa sbagliata. È un piccolo imbarazzo e uno utile, perché è esattamente la classe di errore che rende un benchmark irriproducibile un mese dopo.
Otto schemi, e quali abbiamo effettivamente testato
Sette di questi circolavano come lista di schemi di uno sviluppatore. L'ottavo è nostro, ed è quello che risulta essere il più importante per il lavoro legale.
- Instradamento del modello. Prevedere la complessità del compito, inviare il lavoro facile a un modello piccolo e il lavoro difficile a un modello all'avanguardia.
- Accesso ai rischi per l'esecuzione degli strumenti. Prima che un agente esegua uno strumento, valuta lo strumento, i suoi argomenti e l'attività corrente, e restituisce consenso, blocco o approvazione umana.
- Triage di intenti e domini. Classifica la richiesta in un insieme fisso di intenti prima che l'agente principale inizi a ragionare. Nel diritto si tratta della giurisdizione, dell'area di pratica e del risultato finale.
- Decisioni di ciclo. Dopo ogni passo dell'agente, prevedi se un altro passo sarà probabilmente utile.
- Reranking del recupero. Valuta ogni passaggio recuperato rispetto alla query e passa al contesto solo quelli con il punteggio più alto.
- Guardrail e controlli di policy. Esegui controlli di sicurezza e conformità come classificazioni rapide invece di generare una risposta di ragionamento completa.
- Escalation a un umano. Prevedi se una decisione automatizzata è sufficientemente affidabile da essere eseguita.
- Compattazione del contesto verbatim. Valuta ogni passo di una lunga traccia dell'agente per verificare se sia ancora pertinente all'obiettivo, elimina quelli morti e conserva i superstiti parola per parola.
Abbiamo misurato sei di queste sui nostri dati. Tre funzionano, uno di questi è oggi in produzione. Tre non funzionano. I fallimenti ottengono più spazio qui sotto, perché sono più istruttivi e perché nessun altro li pubblica.
Una nota sul vicinato: un piccolo numero di strumenti basati su questa stessa stack esiste già per il controllo delle citazioni legali, tutti rilasciati nelle ultime due settimane. Sono esperimenti iniziali piuttosto che prodotti operativi, e nessuno pubblica una cifra di accuratezza. Il vuoto in cui stiamo scrivendo non è che nessuno abbia avuto questa idea. È che nessuno ha pubblicato cosa succede quando la si verifica.
Dove funziona: reranking del recupero
Il nostro corpus di statuti MENA contiene 17.004 articoli. Il recupero su di esso è innanzitutto lessicale, il che significa che una query e un articolo che usano parole diverse per lo stesso obbligo possono non corrispondere affatto. Questo è il normale fallimento della ricerca legale in qualsiasi lingua, ed è peggiore in arabo, dove la morfologia pone una maggiore distanza tra un termine di query e la sua corrispondenza.
Abbiamo preso 80 query tenute in disparte, le abbiamo eseguite attraverso il recupero esistente, quindi abbiamo riordinato i candidati ponendo una domanda per candidato: questo articolo risponde a questa domanda.
Riordinamento di un corpus di statuti di 17.004 articoli
Quota di 80 query tenute in disparte in cui l'articolo corretto è stato il primo a tornare
In nove delle 80 query l'articolo corretto non è mai stato recuperato, quindi nessun riordinatore avrebbe potuto promuoverlo. Le query sono state scritte dagli articoli campionati, il che favorisce il recupero lessicale, quindi si legga la differenza piuttosto che i numeri assoluti.
Il rango reciproco medio è passato da 0,719 a 0,869. Dieci casi su dieci verificati manualmente concordavano, inclusi due in cui il modello ha correttamente rifiutato di promuovere qualsiasi cosa perché non esisteva alcun candidato valido. Costo totale: $0,0245.
Un'ulteriore avvertenza. I nostri articoli in arabo e inglese sono divisi per giurisdizione, ogni articolo arabo è egiziano e ogni articolo inglese è emiratino, quindi questa esecuzione non supporta alcuna affermazione sulla lingua.
Funziona perché la domanda ha una risposta giusta. Se questo articolo risponde a questa domanda è determinato dall'articolo e dalla domanda, entrambi di fronte al modello.
Dove funziona: intercettare le risposte che non sono risposte
Prima di adottare Jev, valutavamo le risposte di riferimento con un modello linguistico che agiva da giudice. Quel giudice era generoso in un modo specifico e dannoso. Ha assegnato un perfetto 10.0 al 56% delle risposte che ha valutato, e per un modello il 90% delle risposte è risultato impeccabile in tutte e quattro le dimensioni. Un valutatore senza limiti non misura nulla nella parte superiore del suo intervallo.
Jev ha assegnato lo 0% delle risposte a 9.9 o superiore. Più utilmente, ha rilevato tutti e cinque gli errori API troncati nel set con probabilità comprese tra 0.96 e 0.97. Il giudice precedente aveva valutato quegli stessi cinque errori come 1 su 10 e li aveva mediati nel punteggio di capacità del modello, il che significava che avevamo riportato un tasso di fallimento dell'infrastruttura del 10% come incompetenza legale. Escludendoli, un modello è passato da 5.80 a 7.67.
La cosa più preziosa che il modello ha fatto per i nostri benchmark non è stata giudicare la qualità. È stato notare che una stringa non era una risposta.
Dove funziona, in produzione: il gate di conformità che le regex non riuscivano a vedere
Questo è attivo e si è guadagnato il suo posto catturando qualcosa di imbarazzante.
Ogni pezzo di testo pubblico passa attraverso un gate di pre-verifica prima di essere pubblicato, controllandolo rispetto alle nostre regole di messaggistica. Alcune di queste regole sono linee rosse: non diciamo di sostituire gli avvocati, e non affermiamo che la nostra AI è priva di allucinazioni, perché nessuna delle due affermazioni è vera ed entrambe sono il tipo di affermazione che un regolatore legge attentamente.
Una bozza francese contenente violazioni letterali di entrambe le regole ha superato quel gate con uscita 0, senza alcun riscontro. I pattern regex erano solo in inglese. Il francese per 'sostituiamo gli avvocati', e il francese per 'la nostra AI non ha allucinazioni', sono passati direttamente attraverso un controllo che avrebbe fermato i loro equivalenti inglesi istantaneamente.
Un passaggio semantico ha rilevato entrambi in modo decisivo: 0.90 sull'affermazione implicita, 0.95 sulla linea rossa della sostituzione degli avvocati, 0.83 su come un regolatore lo avrebbe letto. Costo per bozza: circa $0.00005, su otto domande digitate in una singola richiesta parallela.
Il risultato che non ci aspettavamo è che le espressioni regolari (regex) e la semantica si sono rivelate complementari anziché ridondanti. Abbiamo iniziato presupponendo che l'una avrebbe soppiantato l'altra, e su 35 bozze reali abbiamo misurato che ogni regola regex con una controparte semantica intercettava una formulazione diversa dello stesso rischio. La regex intercetta la formulazione letterale. Il passaggio semantico intercetta la parafrasi. La nostra previsione interna era che avremmo potuto eliminare qualcosa, ma i dati hanno detto di no.
Dove si è invertito: chiederle se una citazione è fondata
Ora, il fallimento che ha riorganizzato il nostro modo di pensare.
Abbiamo chiesto a Jev di valutare la fondatezza di 150 risposte legali reali, prodotte da tre modelli all'avanguardia su 50 richieste provenienti dal MENA e dal Regno Unito. Per fondatezza si intende qui: le affermazioni sono supportate, le citazioni sono reali e usate correttamente. È la domanda più importante nell'ambito della Legal AI, ed è la domanda che il nostro audit sull'allucinazione si propone di continuare a porre.
Le risposte contenenti citazioni inventate hanno ottenuto un punteggio di 3.21. Le risposte oneste hanno ottenuto un punteggio di 2.79. La correlazione tra il punteggio composito e le etichette di accuratezza revisionate da umani è stata r = +0.02, il che significa nessuna.
Il controllo non solo non è riuscito a rilevare l'inventiva. L'ha premiata.
Una volta che ne capisci il motivo, non puoi più disconoscerlo. L'Articolo 5bis del Regio Decreto M/13 appare preciso, specifico e autorevole. Non esiste. Un modello incaricato di giudicare la fondatezza solo dal testo non ha nulla con cui confrontarsi, quindi si basa sulle caratteristiche che solitamente accompagnano una scrittura fondata: specificità, densità di citazioni, struttura sicura. L'inventiva produce tutte e tre. La specificità è ciò che sembra l'inventiva, quindi qualsiasi rubrica che premia la specificità premia l'inventiva.
Ora cambia una cosa. Fornisci al modello il passaggio originale insieme all'affermazione e chiedi se questo passaggio supporta questa proposizione. Su una successiva esecuzione riproducibile di 180 coppie dal nostro corpus, il modello ospitato ha raggiunto un AUC di 0.9962 e ha rilevato il 94.4% delle errate attribuzioni con un tasso di falsi allarmi pari a zero.
Stesso modello. Stesso compito in astratto. Risultato opposto, perché una versione è un confronto tra due cose davanti ad esso e l'altra è una ricerca di conoscenza che non può eseguire.
Un'ultima avvertenza, perché è più importante della vittoria. Sullo stesso set di 180 coppie, un semplice controllo di contenimento con `grep` ottiene un AUC di 0.9944 e rileva il 98.9%. Queste coppie sono state costruite su contenimento verbatim, che è precisamente ciò per cui serve `grep`. Considera 0.9962 come un pavimento piuttosto che un soffitto, e considera la fondatezza a livello di parafrasi, dove un classificatore tipizzato dovrebbe effettivamente guadagnarsi il suo stipendio, come non testata da quell'esecuzione.
Il recupero non è un dettaglio di implementazione sotto il passaggio di verifica. Il recupero è ciò che rende possibile la verifica.
Dove ha perso a un contapassi: controllo del ciclo
Abbiamo testato questo in particolare per questo post, e non è sopravvissuto.
Il modello dice: dopo ogni passo dell'agente, chiedi se un altro passo è probabilmente utile, e fermati quando la risposta è no. Abbiamo costruito il test da 52 delle nostre traiettorie di agenti completate, 1.750 passi etichettati. La verità di base per ogni passo era se il passo successivo avesse effettivamente evidenziato informazioni non già presenti da qualche parte nella traiettoria, calcolato da una regola che abbiamo controllato manualmente su 24 su 25.
Prevedere se un agente dovrebbe fare un altro passo
Area sotto la curva ROC, 1.750 passi etichettati su 52 traiettorie completate
Il divario tra Jev e il secondo segnale gratuito è +0.017, con un intervallo di confidenza del 95% da -0.010 a +0.051. Non supera un bootstrap accoppiato. Passi risparmiati a zero perdita di lavoro utile: zero, per tutti e tre.
Abbiamo speso 0,54 $ per non battere una funzione calcolata con una differenza di set.
Due cose sottostanti che valgono più del titolo. La prima è che un periodo di calma non è esaurimento. La regola libera si ferma dopo due passaggi consecutivi che non hanno restituito nulla di nuovo, eseguita come un oracolo sulla propria premessa, ha danneggiato 30 delle 31 traiettorie che ha fermato. Gli agenti spesso diventano silenziosi nel bel mezzo di un lavoro utile.
La seconda spiega l'intero risultato. Dividendo le righe per il tipo di strumento utilizzato dal passaggio successivo, il quadro cambia completamente: 0,742 quando il passaggio successivo scrive o modifica un file, 0,695 quando legge o cerca, e 0,597, quasi per caso, sui comandi shell, dove si trovano il 59% delle nostre righe.
Non stava mai prevedendo se l'agente avesse imparato abbastanza. Stava prevedendo se la cosa successiva che sarebbe tornata sarebbe stata una conferma di scrittura o una pagina di output. Questo è un giudizio sulla forma dell'evento successivo, non sullo stato della conoscenza dell'agente.
Valutiamo onestamente: il nostro corpus sono agenti di codifica e ricerca, non loop di ragionamento legale, e il limite massimo di risparmio era basso fin dall'inizio, perché una trascrizione finita è per definizione una che si è interrotta approssimativamente quando le informazioni sono terminate. Entrambi i fatti limitano la sua generalizzazione. Nessuno dei due salva il modello.
Prova HAQQ AI gratis
Sperimenta la redazione e ricerca legale con IA
Dove ha perso contro una espressione regolare: gate di rischio per le chiamate di strumenti
L'ultimo modello che abbiamo testato, e il più scomodo, perché volevamo che funzionasse.
Gestiamo un'infrastruttura che non deve andare offline. La regola che la protegge attualmente si trova in un file di configurazione che un agente dovrebbe leggere e obbedire. Una regola che dipende dall'essere letta non è un controllo. Un gate che si attiva alla chiamata sì.
Abbiamo quindi etichettato 19.922 chiamate di strumenti reali da 766 delle nostre trascrizioni, ne abbiamo valutate 284 e abbiamo confrontato un classificatore tipizzato con la deny-list che si scriverebbe effettivamente a mano.
| Verità di base | n | Jev | Deny-list, ingenua | Deny-list, robusta |
|---|---|---|---|---|
| Lettura sicura | 121 | 120/121 | 121/121 | 120/121 |
| Distruttiva | 119 | 106/119 | 118/119 | 118/119 |
| Potrebbe portare offline un host attivo | 44 | 25/44 | 8/44 | 20/44 |
Abbiamo richiesto che ogni chiamata distruttiva venisse intercettata. Il classificatore ha raggiunto l'89,1%, al di sotto di entrambe le deny-list. L'espressione regolare vince la classe per cui il test è stato creato.
C'è una vera vittoria nascosta in tutto questo. Sulla questione specifica se una chiamata potesse mettere offline un host in tempo reale, una domanda dedicata sì-o-no ha intercettato 21 su 22 con un tasso di falsi allarmi del 3,4%, dove la più forte delle due deny-list scritte a mano ne ha intercettate 8 su 22. Unendo le due, il tasso di chiamate rischiose che sfuggono si dimezza. A undici centesimi per mille chiamate, il costo non è ciò che ti ferma. La raccomandazione che ne è derivata è comunque di distribuire l'espressione regolare e mantenere il classificatore come seconda opinione, mai come gate.
Il risultato più pulito dell'intero programma si trova all'interno di questo test, e riguarda il modo in cui si pone la domanda piuttosto che ciò che si chiede. Stesso modello, stesse righe, stesso pomeriggio. La domanda concreta, questa chiamata può mettere offline uno di questi specifici host in tempo reale, ha raggiunto il 95,5% di richiamo con un tasso di falsi allarmi del 3,4%. La domanda astratta, questa azione è irreversibile, ha richiesto una soglia molto più permissiva per raggiungere un richiamo paragonabile e ha trascinato il tasso di falsi allarmi al 34,6% per arrivarci.
Lo avevamo imparato in precedenza e lo avevamo scritto come massima: nomina il test concreto, non la categoria astratta. Questa è la prima volta che lo abbiamo come confronto controllato piuttosto che come aneddoto, e la dimensione del divario ci ha sorpreso.
Un'altra cosa da quel test, con i suoi limiti. Abbiamo provato a convincere il classificatore ad approvare chiamate che aveva bloccato, usando otto payload di iniezione scritti a mano su 384 chiamate accoppiate, inseriti nel comando, nella descrizione e nel contesto del compito. Nessuno ha invertito in modo affidabile una chiamata bloccata in permessa. Questo è un risultato reale e piccolo: otto payload scritti dalla stessa persona che ha costruito il test non sono un red team, e una deny-list è immune a questo per costruzione piuttosto che per fortuna. La documentazione di TypeSafe elenca che lo stato non è trattato come ostile tra le limitazioni del modello, e per un gate di sicurezza quella limitazione ricade direttamente sull'input controllato da un attaccante.
L'ottavo schema, e perché è quello legale
Tutto quanto sopra è tratto dall'ingegneria generale degli agenti. Questo è nostro, e deriva da un vincolo che si manifesta realmente solo nel diritto.
Le lunghe esecuzioni degli agenti superano il loro contesto, e la soluzione standard è che un modello linguistico riassuma la traccia finora. Per la maggior parte dei software va bene. Per il lavoro legale è un disastro silenzioso, perché un riassunto di uno statuto è un nuovo documento. Contiene nuove parole. Quelle parole sono state scritte da un modello, non da un legislatore, e ogni passaggio successivo ragiona sulla parafrasi piuttosto che sulla legge.
L'alternativa è compattare senza parafrasare. Valuta ogni passaggio della traccia per vedere se è ancora rilevante per l'obiettivo attuale, scarta quelli che non lo sono e conserva le parole dei sopravvissuti esattamente come sono. Nulla viene riscritto. Il contesto si accorcia perché le cose sono state rimosse, non perché le cose sono state riformulate.
Un riassunto di uno statuto è un nuovo documento. Un elenco filtrato di statuti sono ancora gli statuti.
Questo è il modello che ci interessa di più ed è quello che non abbiamo ancora misurato, quindi trattatelo come una posizione di design piuttosto che un risultato. Lo diciamo ad alta voce perché è il tipo di problema per cui un modello decisionale è insolitamente adatto, e perché non abbiamo visto nessun altro inquadrare la compattazione come un requisito di correttezza piuttosto che come un'ottimizzazione dei costi.
Due cose sul lavoro legale di cui nessuno ti avverte
Non riesce a vedere un documento scannerizzato. Jev elabora il testo. Una grandissima parte dei documenti legali reali, in particolare in tutta l'area MENA, arrivano come fotografie di carta. Ciò significa che la pipeline che lo precede fa tutto il lavoro che determina se riceve un input corretto, e qualsiasi fiducia riporti è condizionata da un passaggio OCR di cui non sa nulla. Esistono reimplementazioni aperte della stessa architettura che funzionano su modelli di base con capacità visive, che è la direzione in cui alla fine andrà, ma il modello ospitato che avete davanti oggi è cieco.
Le abbreviazioni legali lo rovinano in un modo che sembra un bug ma non lo è. Gli abbiamo chiesto di classificare una richiesta di revisione di un MSA arabo e di evidenziarne le modifiche. La "legalità" è tornata a 0,30, il che per una richiesta chiaramente legale sembra un fallimento. Isolate la frase e il quadro si risolve: MSA da solo ottiene 0,97, Master Services Agreement 0,98, un MSA scritto in arabo 0,96, e Arabic MSA crolla a 0,30. Mettere la parola "Arabic" immediatamente prima di MSA trasforma l'acronimo da Master Services Agreement a Modern Standard Arabic.
Il modello ha ragione. La frase è genuinamente ambigua, e sarebbe ambigua anche per un lettore umano. Ma il lavoro legale nella regione MENA genera costantemente questa esatta costruzione, quindi qualsiasi pipeline che si basi su un'etichetta di documento la incontrerà, e in un benchmark verrà interpretato come un fallimento del modello quando è un artefatto di ambiguità dell'input. Se state valutando un classificatore su testo legale, verificate la presenza di un'abbreviazione ambigua prima di concludere che il modello non è in grado di gestire la vostra giurisdizione.
La regola che ne è derivata
Sei superfici, tre vittorie, tre sconfitte. Il modello nelle sconfitte è la cosa che vale la pena portare via.
La riorganizzazione funziona perché "questo articolo risponde a questa domanda" ha una risposta che l'articolo e la domanda concordano tra loro. Il "grounding" delle citazioni funziona quando si consegna la fonte e si inverte quando non lo si fa, perché senza la fonte la domanda diventa una ricerca di conoscenza. Il controllo del ciclo fallisce perché "questo agente ha imparato abbastanza" non è determinato da nulla nella traiettoria. Il suggerimento di link interni, che abbiamo anche testato, ha fallito allo stesso modo: alla domanda se un lettore avrebbe avuto un vero motivo per cliccare da una pagina all'altra, i punteggi su 761 link curati da esseri umani sono tornati a 0,582 per i link reali e 0,537 per le coppie che nessun editore aveva mai collegato, un divario di 0,045, con i controllori manuali che concordavano su 12 su 20.
Prima di basarvi su un giudizio, chiedete qual è la sua verità fondamentale. Se la risposta onesta è una preferenza dell'editore, aspettatevi un divario di circa 0,05 e pianificate l'intervento umano.
Questo è lo stesso confine che la nostra stessa indagine sulle citazioni false ha trovato dall'altra direzione, ed è per questo che giudichiamo gli strumenti in base al fatto che controllino se una citazione dice ciò che affermano, non semplicemente che esista.
Cosa diremmo a chi valuta la Legal AI
Quattro cose, solo una delle quali riguarda questo modello in particolare.
Chiedi a cosa è ancorato il controllo. La nostra IA verifica le citazioni non è un'architettura. Verificare che un caso esista è una ricerca nel database. Verificare che il caso affermi ciò che la risposta sostiene è un confronto, e richiede la fonte a portata di mano al momento del giudizio. I prodotti che fanno il primo e lo descrivono come il secondo sono la norma, non l'eccezione.
Chiedi il tasso di fallimento, non il tasso di successo. Ogni strumento in questa categoria pubblica un numero che lo lusinga. Pochissimi pubblicano ciò che hanno misurato e perso. La nostra onestà ha dei limiti che meritano di essere dichiarati: il primo passaggio automatizzato nell'etichettatura di quel corpus di "tool-call" era sbagliato all'86% nella sua classe più importante, tutto nella stessa direzione, e lo abbiamo scoperto tramite controllo manuale piuttosto che con astuzia.
Chiedi contro cosa è stato valutato il benchmark. Questo inganna quasi tutti. Un benchmark può essere valutato rispetto alla "ground truth" o rispetto all'accordo con un modello linguistico all'avanguardia. Il secondo è molto più economico e molto più debole, perché essere d'accordo con GPT include essere d'accordo con gli errori di GPT. Quando un fornitore riporta l'accuratezza, la domanda non è quanto sia alto il numero. È a cosa è stato paragonato il numero.
Fai attenzione a un numero che viene asserito piuttosto che misurato. Il grafico di lancio di TypeSafe mostra un tasso di allucinazione dello 0%, e la nota a piè di pagina sotto di esso afferma, a loro dire, che il numero non è empirico ed è aggiunto per costruzione perché la corrispondenza dello schema è imposta piuttosto che osservata. Loro lo rivelano. Il titolo sopra il grafico no. L'affermazione sottostante è vera e ristretta: non otterrai mai un valore al di fuori del tuo schema. Non è un'affermazione che il valore sia corretto. Un analista indipendente ha sottolineato questo punto una settimana dopo il lancio, ed è un punto valido.
Cosa è realmente cambiato per noi
Non il costo. Scambiare una chiamata di modello linguistico con una tipizzata fa risparmiare pochi centesimi, e i centesimi non sono mai stati il problema.
Ciò che è cambiato è che una decisione che il sistema stava già prendendo in silenzio ora ha un numero. La revisione contrattuale a 0.91 contro il contenzioso a 0.09 è un percorso che puoi automatizzare e registrare. 0.52 contro 0.46 è un lancio di moneta con un'etichetta, e richiede un essere umano. Un modello linguistico avrebbe dato la stessa risposta in entrambi i casi, con una frase sicura, senza alcun modo per distinguere le due situazioni.
Per un prodotto in cui l'errore è l'intera superficie di rischio, questo vale più di qualsiasi multiplo di velocità su un grafico del fornitore.
L'abitudine che manterremmo anche se non inviassimo mai più una richiesta: passare attraverso il tuo agente e trovare ogni chiamata che si limita a selezionare qualcosa. Quale strumento usare dopo. È spam. Questo pezzo è rilevante. Questo ha bisogno di un umano. Questo diff è rischioso. Nessuno di questi sono compiti di scrittura. Sono dichiarazioni condizionali che qualcuno ha esternalizzato a un modello di frontiera, e la maggior parte di esse non ne ha bisogno.
Punti Chiave
- Un modello che non genera testo è uno strumento reale per un imbracatura legale, nei luoghi specifici in cui un giudizio è un confronto tra cose che puoi mettergli di fronte.
- Interrogato a valutare la "groundedness" sul solo testo, ha assegnato punteggi a citazioni fabbricate più alti rispetto a quelle oneste, 3.21 contro 2.79, con una correlazione all'accuratezza reale di r = +0.02. Il recupero è ciò che rende possibile la verifica, non un dettaglio di implementazione sottostante.
- È in produzione sul nostro "compliance gate", dove ha rilevato violazioni "red-line" in una bozza francese che la nostra regex solo inglese aveva passato all'uscita 0. Le regex e i controlli semantici si sono rivelati complementari, non ridondanti, contro la nostra stessa previsione.
- Il "reranking" del nostro corpus di statuti di 17.004 articoli ha spostato il richiamo al rango 1 da 0.638 a 0.850 per meno di tre centesimi.
- Il controllo ad anello non ha battuto un contapassi gratuito in un test a coppie, e la sua apparente abilità è crollata a quasi casualità una volta che abbiamo controllato che tipo di azione sarebbe seguita.
- Un "tool-call risk gate" ha richiamato l'89,1% delle chiamate distruttive dove una "deny-list" scritta a mano ne richiamava il 99,2%. Stiamo rilasciando la regex.
- Per il lavoro legale in particolare: non può leggere un documento scansionato, e l'arabo MSA viene letto come "Modern Standard Arabic" anziché "Master Services Agreement", abbassando la legalità da 0.97 a 0.30.
- La compattazione dovrebbe rimuovere, non riscrivere. Un riassunto di uno statuto è un nuovo documento.
- Chiediti qual è la verità fondamentale per un giudizio prima di costruirci sopra. Nessuna verità fondamentale, nessuno strumento.