In breve: la maggior parte dei prodotti di Legal AI sono architettonicamente identici. La tua domanda si rivolge a un modello di uso generale con un template di prompt attorno, e non puoi capirlo dall'interfaccia. La differenza che conta avviene prima che il modello venga chiamato. Quattro domande alla fine di questo post ti diranno che tipo di sistema ti sta vendendo qualsiasi fornitore, in circa dieci minuti di demo.
Ogni avvocato che valuta la Legal AI alla fine si pone la stessa domanda, di solito circa otto minuti dopo l'inizio di una demo: in cosa si differenzia dall'utilizzo di ChatGPT?
È la domanda giusta, e la maggior parte dei fornitori risponde male. Parlano di dati di addestramento, o di un corpus proprietario, o di un fine-tuning. Queste risposte sono difficili da verificare e, il più delle volte, non sono il punto in cui risiede effettivamente la differenza.
La risposta onesta è architettonica, e si riduce a una cosa: dove avviene il "pensiero"?
Il problema del "wrapper" è reale e invisibile dall'esterno
Una gran parte dei prodotti di Legal AI funziona così. Tu digiti una domanda. Il prodotto la racchiude in un prompt template, alcune istruzioni su come essere un assistente legale utile, magari qualche esempio, e inoltra il tutto a un modello di uso generale. Il modello risponde. Il prodotto formatta la risposta in modo gradevole e te la mostra.
Non c'è nulla di disonesto in questo. Può essere genuinamente utile. Ma significa che la qualità del prodotto è quasi interamente la qualità del modello, e il modello è lo stesso a cui il tuo avversario può accedere per venti dollari al mese.
La parte scomoda per un acquirente è che non è possibile capirlo dall'interfaccia. Un "wrapper" e un motore costruito appositamente sembrano identici: una casella di testo, una risposta in streaming, alcune citazioni sotto. La differenza è a monte, dove nessuno può vederla, ed è esattamente per questo che così pochi fornitori vengono messi sotto pressione su questo aspetto.
Dove il ragionamento appartiene davvero
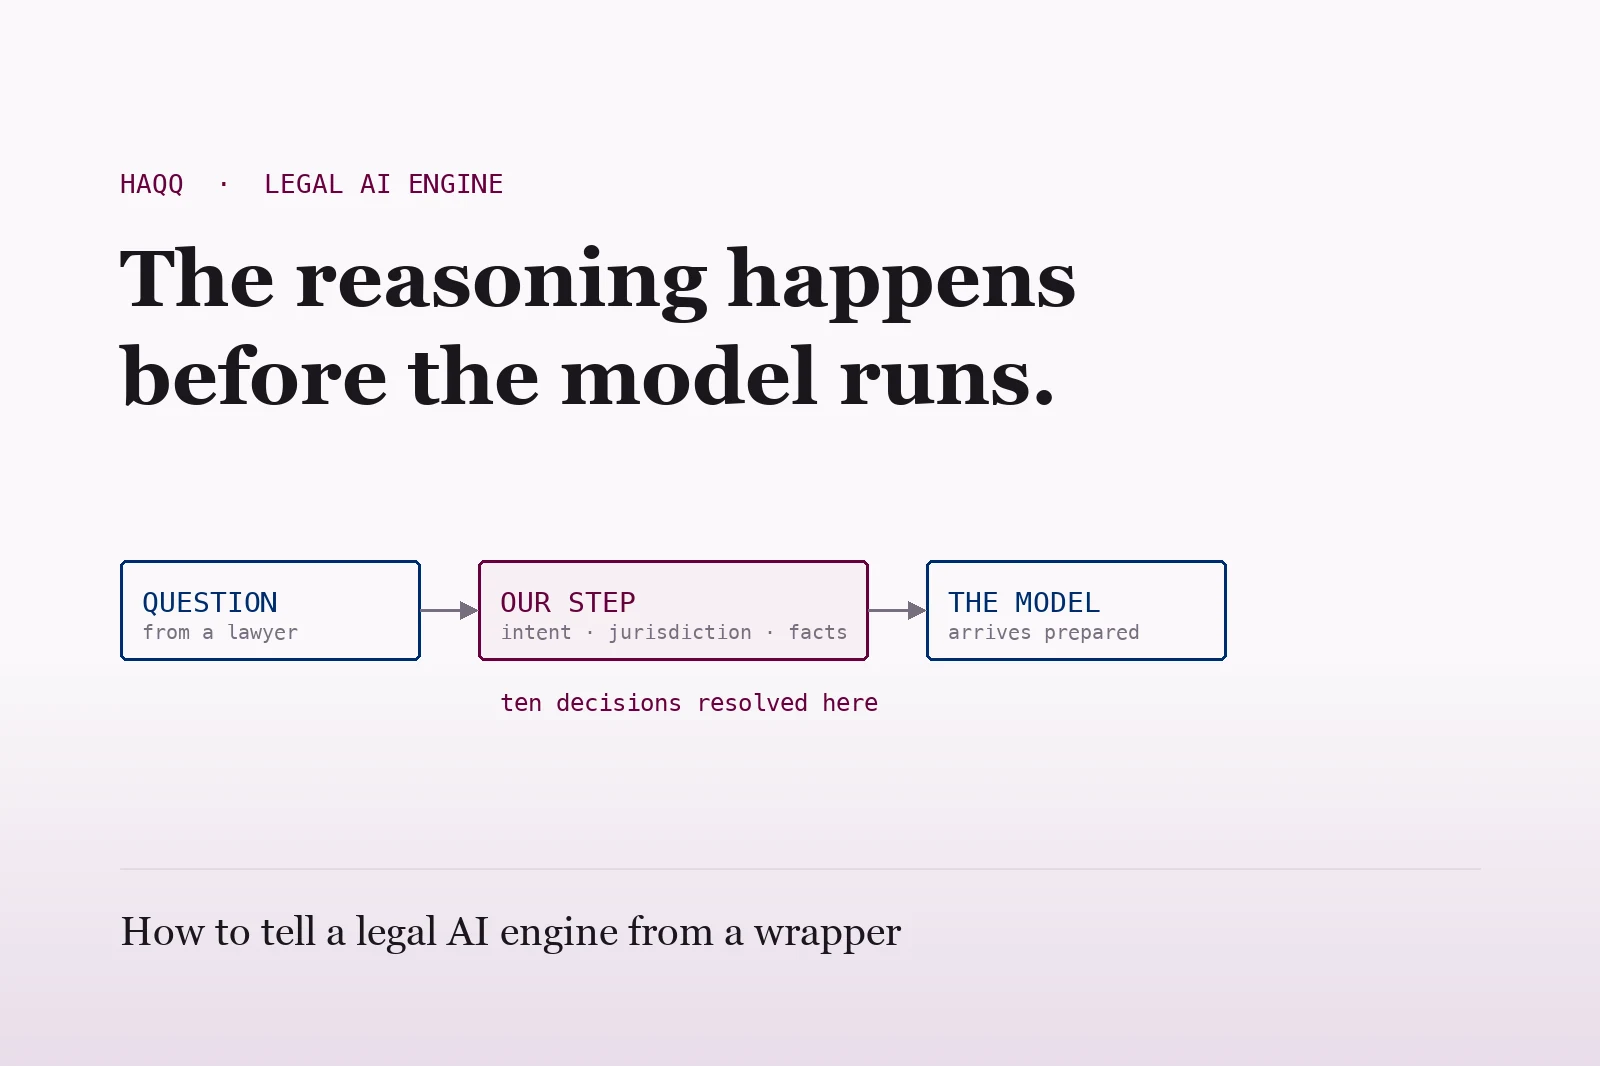
Quando una domanda arriva ad HAQQ, non va prima a un modello generale. Passa attraverso un passaggio che noi possediamo e controlliamo, il cui intero compito è capire qual è effettivamente la richiesta e configurare tutto ciò che accade dopo.
Questo passaggio risolve le questioni che un collaboratore competente stabilirebbe prima di iniziare il lavoro, e le risolve come dati strutturati piuttosto che come prosa:
- Cosa viene effettivamente richiesto. Non le parole digitate alle 23:00 tra due chiamate, ma la domanda sottostante, riformulata in modo preciso e completo. Questo funziona nativamente in arabo e francese, oltre che in inglese, piuttosto che come una traduzione applicata in seguito.
- Che tipo di lavoro legale è questo. Redazione, ricerca, revisione, comparazione, una questione procedurale. Ognuno richiede una forma di risposta diversa, e deciderlo in anticipo è molto diverso dallo sperare che un modello generale lo inferisca.
- Quale giurisdizione è in gioco, e separatamente, in quale lingua è redatta la legge applicabile. Queste due non sono frequentemente le stesse, e trattarle come una sola è una fonte di errore silenziosa e comune.
- I fatti, come oggetti. Parti, date, obblighi, importi, legge applicabile, tipo di documento, estratti dalla prosa e trasformati in dati strutturati prima che qualsiasi cosa costosa li legga.
- Cosa la domanda richiede, e cosa no. Quali capacità specializzate mettere in campo, quanta profondità di ragionamento la domanda effettivamente giustifica, e se rientra affatto nell'ambito di applicazione.
Solo allora il modello generico viene eseguito. E arriva già preparato: le capacità pertinenti caricate, i fatti estratti, la giurisdizione identificata, l'ambito deciso.
Il modello è l'ultimo passo della catena, non il primo.
Perché questo produce una risposta migliore, non solo più economica
Due meccanismi, e il secondo ci ha sorpreso più del primo.
L'attenzione è un budget
La finestra di contesto di un modello è finita, e tutto ciò che vi si inserisce compete per l'attenzione del modello. Caricare ogni capacità di un sistema in ogni richiesta consuma una parte significativa di quella finestra prima che il documento effettivo dell'avvocato venga esaminato. Portare solo quelle rilevanti lascia spazio a ciò che conta: il contratto, la legge, i fatti.
Il parsing non è il ragionamento
Questo è l'effetto più ampio. Quando un modello riceve un paragrafo di prosa, una parte significativa del suo lavoro consiste nel capire cosa contiene il paragrafo. Quando riceve fatti strutturati - queste parti, questa legge applicabile, questo obbligo, questa data - quel lavoro è già fatto, e l'intero budget è dedicato alla questione legale.
La conseguenza pratica è che lo stesso modello generico produce un lavoro legale sensibilmente migliore all'interno di un sistema come questo rispetto a quanto farebbe all'interno di un involucro. Il modello non è cambiato. Ciò che gli abbiamo fornito sì.
Le parti che nessuno inserisce in una demo
Due cose che non vengono mai incluse in una presentazione di vendita, ed entrambe decidono se il prodotto funziona in un vero martedì.
Acquisizione documenti. Una gran parte del lavoro legale non arriva come testo pulito. Arriva come una fotografia di un documento timbrato, una scansione di un fax, un PDF che qualcuno ha stampato e scansionato di nuovo in modo storto. Trattiamo la lettura di questi documenti come un problema ingegneristico di prim'ordine piuttosto che come un ripensamento di pre-elaborazione, perché se un numero di clausola viene letto male all'ingresso, nessuna quantità di ragionamento a valle lo recupererà. Il sistema ragionerà impeccabilmente sul numero sbagliato.
Memoria come struttura, non come trascrizione. Il motore mantiene le relazioni tra le vostre pratiche nel tempo e le utilizza quando una domanda lo richiede. Questo è diverso dall'incollare gli ultimi venti messaggi nel prompt. È ciò che consente al sistema di sapere che la controparte nell'accordo di riservatezza che state esaminando oggi è la stessa di una controversia di due mesi fa.
Cosa questa architettura non risolve
Preferiamo dirvelo piuttosto che farvelo scoprire.
Non elimina gli errori. Qualsiasi sistema basato su un modello linguistico può produrre una risposta sbagliata, e un fornitore che vi dice il contrario o non è attento alle parole o spera che non controlliate. Una buona architettura rende l'errore più raro e rilevabile: affermazioni generate rispetto a fonti recuperate, citazioni che potete aprire e flag espliciti laddove la legge è genuinamente ambigua piuttosto che una risoluzione sicura di qualcosa di irrisolto.
Non elimina l'avvocato. Tutto ciò è progettato partendo dal presupposto che un professionista esamini l'output e lo firmi. Questa non è una limitazione per cui ci scusiamo. È il vincolo di progettazione, ed è la ragione per cui l'architettura è fatta in questo modo.
Non rende la copertura universale. La qualità di Legal AI varia in base alla giurisdizione, a quanto bene sia digitalizzata la legge di riferimento e a quanto di essa sia effettivamente pubblico. A chiunque vi citi un unico numero di copertura globale dovrebbe essere chiesto cosa include. Ci viene chiesto spesso, e preferiremmo rispondere a riguardo della vostra giurisdizione piuttosto che sventolarvi un numero.
Come testare qualsiasi fornitore per questo in una demo
Non avete bisogno di vedere il diagramma architettonico di nessuno. Quattro domande, circa dieci minuti, e funzionano per ogni fornitore della categoria, inclusi noi.
1. Chiedete qualcosa al di fuori del diritto
Un modello generale avvolto in un prompt legale di solito risponderà a una domanda medica o finanziaria, perché, in fondo, è un modello generale. Un sistema che stabilisce l'intento prima di generare dovrebbe rifiutarsi e spiegare perché.
2. Ponete la stessa domanda in due lingue
Non una versione tradotta. La stessa domanda legale, una volta in inglese e una volta in arabo o francese. Se la sostanza della risposta cambia, la lingua viene gestita dopo il ragionamento piuttosto che prima.
3. Fai una scansione di scarsa qualità
Fotografa un documento di traverso, con scarsa illuminazione, e caricalo. Questo è il test più predittivo dell'intera demo, perché è l'input reale più comune e quello meno dimostrato.
4. Chiedi cosa non sa
Spingi verso un'area del diritto ambigua, incerta o con fonti scarse. Un sistema ottimizzato per produrre sempre una risposta ne produrrà una. Un sistema costruito per il lavoro professionale ti dirà che il terreno è incerto e ti mostrerà il perché.
Se un fornitore si sente a suo agio con tutti e quattro, l'architettura è probabilmente reale. Se la demo li evita, anche questa è un'informazione.
Punti chiave
- La differenza significativa tra i prodotti Legal AI è architetturale e invisibile dall'interfaccia. Chiedi dove avviene il ragionamento.
- Svolgere un lavoro strutturato prima della chiamata del modello migliora la qualità dell'output, non solo il costo. Un modello a cui vengono forniti fatti estratti spende il suo budget in diritto anziché nell'analisi.
- I componenti poco appariscenti decidono le prestazioni nel mondo reale. La qualità dell'acquisizione dei documenti è più predittiva del fatto che uno strumento funzioni un martedì rispetto a qualsiasi punteggio di benchmark.
- Quattro domande di demo, fuori tema, due lingue, una scansione scadente e un'area del diritto incerta, ti diranno che tipo di sistema ti viene venduto.
- Il motore Justinian e il suo ragionamento
- 45 segnali di allarme nella valutazione di un fornitore di Legal AI
- Legal AI con intervento umano (Human in the loop)
- Ingegneria del contesto per la Legal AI
Prova HAQQ AI gratis
Sperimenta la redazione e ricerca legale con IA