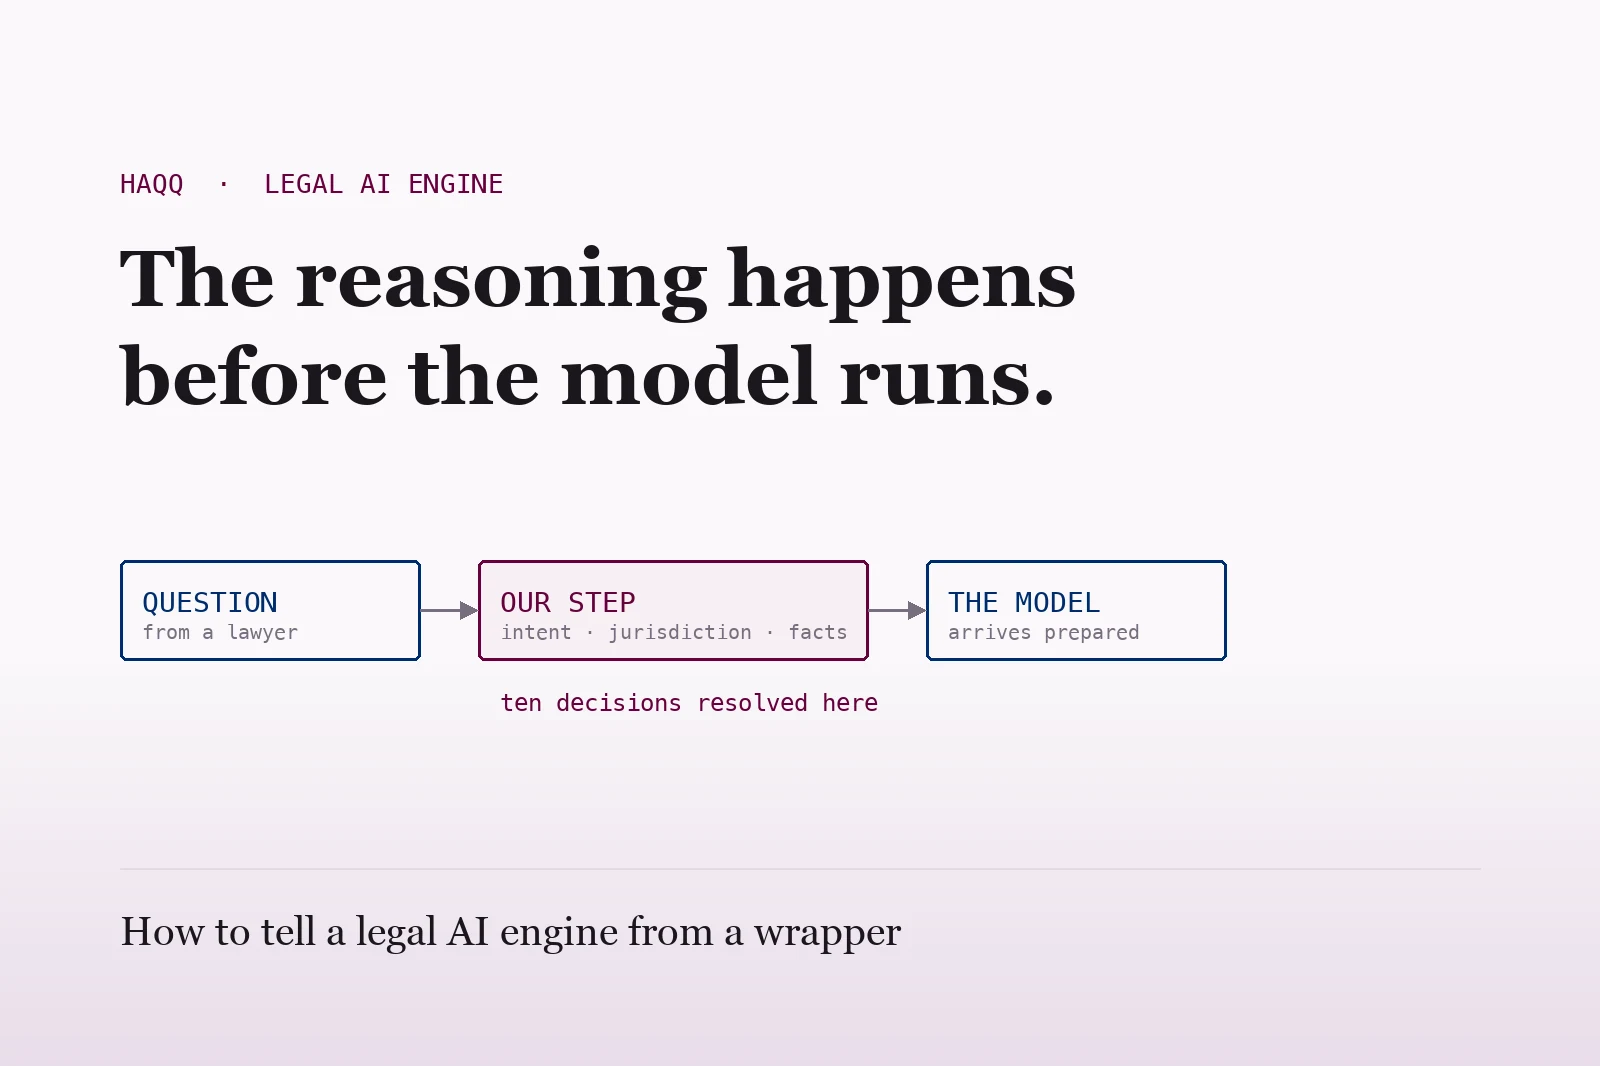
باختصار: أنفقنا أقل من 0.20 دولار لاختبار ما إذا كان النموذج الذي لا يولد أي نص ينتمي إلى مكدس Legal AI الخاص بنا. لقد فعل ذلك، في ثلاثة أماكن، وهو قيد الإنتاج في أحدها. لقد فشل في ثلاثة أماكن أخرى، وانعكس أحد هذه الإخفاقات بشكل كامل لدرجة أن الإجابات التي تحتوي على استشهادات ملفقة سجلت درجات أعلى من الإجابات الصادقة. القاعدة التي خرجت منها هي الجزء المفيد: هذه الفئة من النماذج قوية حيث يكون للحكم إجابة موضوعية تحسمها الأدلة المقدمة، وضعيفة في أي مكان يكون فيه الحكم مجرد ذوق.
الفكرة، ولماذا أخذناها على محمل الجد
هناك حجة متداولة مفادها أن معظم وكلاء الذكاء الاصطناعي يهدرون أغلى مواردهم على قرارات لم تحتاج أبدًا إلى جملة. توجيه طلب إلى النموذج الصحيح هو قرار. تحديد ما إذا كانت مكالمة الأداة آمنة هو قرار. ترتيب خمسين وثيقة مسترجعة هو خمسون قرارًا. لا شيء من هذه ينتج نثراً يقرأه أحد، ومع ذلك يتم تسليمها جميعًا إلى نموذج يحاسب بالكلمة ويجيب في فقرات.
في سبتمبر 2026، أطلقت TypeSafe AI نموذجًا مبنيًا على تلك الحجة. Jev هو ما يسمونه نموذج النظام الأول (System One)، والخاصية المميزة له هي أنه لا يولد أي نص على الإطلاق. تقوم بـ POST لكتلة من الحالة بالإضافة إلى مجموعة من الأسئلة المكتوبة، وتحصل على احتمالات معايرة، يتم تقييمها جميعًا في رحلة ذهاب وعودة متوازية واحدة.
هناك ثلاثة بدائيات ولا يوجد رابع. noul هو سؤال بنعم أو لا يعيد احتمالاً بين 0 و 1، وهذا الاحتمال هو الثقة: 0.5 يعني رمي عملة، وليس شدة متوسطة. choice يختار خيارًا واحدًا من قائمة تحددها، ولا يمكنه فعليًا إرجاع خيار لم تعلنه. score يضع المدخل على مقياس ترتيبي تصفه بالكلمات، ويعيد المتوسط المرجح بالاحتمال، لذا فإن تقسيم 70/30 عبر مستويين يعود كـ 1.30 بدلاً من 1 أو 2.
هذا هو السطح بأكمله. لا يمكنه تلخيص أو إعادة صياغة أو صياغة أو استخراج نطاق أو البحث عن أي شيء. ليس لديه قاعدة معرفية ولا استرجاع. يجيب على الأسئلة التي أعلنت مساحة إجاباتها، حول حالة سلمتها إليه.
الجزء الذي يسهل تفويته
تتمثل الغريزة في تصنيف هذا تحت مصنف سريع ورخيص. هذا يقلل من شأن ما تغير بالفعل، وهو ليس السعر بل الترتيب.
يكتب نموذج اللغة رمزًا واحدًا في كل مرة، لذا لا يمكن أن يوجد الرمز التاسع حتى يوجد الرمز الثامن. اسأله أربعة أسئلة غير مرتبطة حول عقد وستصطف تلك الأحكام الأربعة المستقلة خلف بعضها البعض، وتعود ككتلة تقوم بتحليلها والتحقق منها وإعادة المحاولة عندما يكون الشكل خاطئًا. يحذف Jev قائمة الانتظار. أنت تعلن مساحة الإجابة مسبقًا وكل سؤال يتم حله مقابل نفس الحالة مرة واحدة. النص هو خط يجب أن تسير عليه. مساحة الإجابة هي غرفة تراها كلها مرة واحدة.
| نموذج لغة Frontier | Jev | |
|---|---|---|
| الناتج | سلسلة تقوم بتحليلها والتحقق منها | قيمة مكتوبة يتفرع عنها الكود الخاص بك |
| الترتيب | تسلسلي، كل رمز مشروط بالرمز الأخير | لا شيء، جميع الأسئلة بالتوازي |
| عدم اليقين | مدفون في نثر واثق | احتمال صريح على كل خيار |
| وضع الفشل | شكل خاطئ، خيار مخترع، رفض | إجابة خاطئة صالحة للمخطط |
| هل يمكنه الكتابة؟ | نعم، هذا هو المنتج | لا. ليس جملة، ليس نطاقًا، ليس كودًا |
| هل يمكنه البحث عن الأشياء؟ | باستخدام الأدوات، نعم | أبدًا. لا استرجاع، لا قاعدة معرفية |
صف وضع الفشل هذا هو ما يهم في القانون، ويجدر أن نكون صريحين بشأنه. الضمان المعروض هو أنك لن تحصل أبدًا على قيمة خارج المخطط الخاص بك. إنه ليس ضمانًا بأن القيمة صحيحة.
خطأ صحيح المخطط يعيد المبلغ للعميل الخطأ بنفس سرعة الخطأ المشوه.
بالنسبة لشركة Legal AI، الكلمة المثيرة للاهتمام في كل هذا هي معاير. الرقم الذي يمكنك التفرع عليه في الكود هو كائن مختلف عن فقرة يجب على المحامي قراءتها والثقة بها. لقد كتبنا في منشور طبقة التنسيق الخاصة بنا أن الجزء من Legal AI الذي يحدد ما إذا كانت الاقتباسات صحيحة غير مرئي من الخارج. وهذا مرشح لملء جزء من هذا الجزء غير المرئي.
لذا قمنا بتشغيله عبر مكدسنا بالكامل. كل قياس أدناه هو خاص بنا، على مجموعتنا الخاصة، وتلك التي سارت بشكل سيء موجودة هنا أيضًا.
ما قمنا بقياسه، وما كلفه
عشرة أسطح، ثلاث عشرة تذكرة مغلقة، أقل من 0.20 دولار إجمالي الإنفاق. هذا ليس تفاخرًا بالتقشف. إنه السبب الذي جعل التجربة تستحق التشغيل على الإطلاق: بجزء من سنت لكل حكم يمكنك تحمل تكلفة التحقق من كل حدث بدلاً من أخذ عينات، وتكلفة النتيجة الخالية لا تكاد تذكر.
وقت الاستجابة، المقاس على حركة المرور الخاصة بنا مع اتصال دافئ مفتوح: 292 مللي ثانية في المتوسط، 374 مللي ثانية في p90، 395 مللي ثانية في p95، عبر 40 مكالمة. حوسبة الخادم وحدها 112 مللي ثانية. أول قياس لنا قال 700 مللي ثانية، وكررنا هذا الرقم داخليًا لمدة أسبوع قبل أن نلاحظ أنه كان خاطئًا. لم نقم بإعادة استخدام الاتصال أبدًا، لذا كانت كل مكالمة تدفع ثمن مصافحة جديدة. نفس واجهة برمجة التطبيقات، نفس إصدار النموذج، قياس دقيق للشيء الخاطئ. إنه إحراج صغير ولكنه مفيد، لأنه بالضبط فئة الخطأ التي تجعل المعيار غير قابل لإعادة الإنتاج بعد شهر.
ثمانية أنماط، وتلك التي اختبرناها بالفعل
سبعة من هذه الأنماط تم تداولها كقائمة أنماط للمطورين. الثامن هو خاص بنا، وهو الذي تبين أنه الأكثر أهمية للعمل القانوني.
- توجيه النموذج. توقع تعقيد المهمة، أرسل العمل السهل إلى نموذج صغير والعمل الصعب إلى نموذج متطور.
- بوابات المخاطر لاستدعاء الأدوات. قبل أن يقوم الوكيل بتنفيذ أداة، قم بتقييم الأداة بالإضافة إلى وسائطها بالإضافة إلى المهمة الحالية، ثم أعد السماح أو الحظر أو الموافقة البشرية.
- فرز النية والمجال. صنف الطلب إلى مجموعة ثابتة من النوايا قبل أن يبدأ الوكيل الرئيسي في التفكير. في القانون، هذا هو الاختصاص القضائي، ومجال الممارسة، والمخرجات.
- قرارات الحلقة. بعد كل خطوة من خطوات الوكيل، توقع ما إذا كانت خطوة أخرى من المحتمل أن تكون مفيدة.
- إعادة ترتيب الاسترجاع. قم بتقييم كل مقطع مسترجع مقابل الاستعلام ومرر فقط المقاطع ذات الدرجات الأعلى إلى السياق.
- الحواجز الوقائية وفحوصات السياسة. قم بإجراء فحوصات السلامة والامتثال كتصنيفات سريعة بدلاً من إنشاء استجابة تفكير كاملة.
- التصعيد إلى إنسان. توقع ما إذا كان القرار الآلي موثوقًا به بما يكفي للتنفيذ.
- ضغط السياق الحرفي. قم بتقييم كل خطوة من تتبع وكيل طويل لتحديد ما إذا كانت لا تزال تؤثر على الهدف، وتخلص من الخطوات الميتة، واحتفظ بالناجيات كلمة بكلمة.
لقد قمنا الآن بقياس ستة من هذه على بياناتنا الخاصة. ثلاثة تعمل، واحدة منها قيد الإنتاج اليوم. وثلاثة لا تعمل. الفشل يحصل على مساحة أكبر أدناه، لأنه أكثر إفادة ولأن لا أحد آخر ينشره.
ملاحظة حول الجوار: عدد قليل من الأدوات المبنية على هذه المكدس نفسه موجودة بالفعل للتحقق من الاستشهادات القانونية، تم شحنها كلها خلال الأسبوعين الماضيين. إنها تجارب مبكرة وليست منتجات عاملة، ولا تنشر أي منها رقم دقة. الفجوة التي نكتب فيها ليست أنه لم يأت أحد بهذه الفكرة. بل هي أن لا أحد نشر ما يحدث عندما تتحقق منها.
حيث يعمل: إعادة ترتيب الاسترجاع
يحتوي المدونة التشريعية الخاصة بمنطقة الشرق الأوسط وشمال أفريقيا على 17,004 مادة. يعتمد الاسترجاع فيها على المعجم أولاً، مما يعني أن استعلامًا ومادة تستخدمان كلمات مختلفة لنفس الالتزام يمكن أن يفشل كل منهما في العثور على الآخر تمامًا. هذا هو الفشل العادي للبحث القانوني بأي لغة، وهو أسوأ في اللغة العربية، حيث تضع الصرفيات مسافة أكبر بين مصطلح الاستعلام والمطابقة.
أخذنا 80 استعلامًا محجوزًا، قمنا بتشغيلها من خلال الاسترجاع الحالي، ثم أعدنا ترتيب المرشحين عن طريق طرح سؤال واحد لكل مرشح: هل تجيب هذه المادة على هذا السؤال.
إعادة ترتيب مدونة تشريعية تحتوي على 17,004 مادة
نسبة الاستعلامات الـ 80 المحجوزة حيث جاءت المادة الصحيحة أولاً
في تسعة من الاستعلامات الثمانين، لم يتم استرجاع المقال الصحيح على الإطلاق، لذلك لم يتمكن أي معاد ترتيب من ترقيته. تمت كتابة الاستعلامات من المقالات التي تم أخذ عينات منها، مما يضفي طابعًا إيجابيًا على الاسترجاع المعجمي، لذا اقرأ الفرق بدلاً من الأرقام المطلقة.
انتقل متوسط الرتبة المتبادلة من 0.719 إلى 0.869. وافقت عشر حالات تم فحصها يدويًا من أصل عشرة، بما في ذلك اثنتين حيث رفض النموذج بشكل صحيح ترقية أي شيء لأنه لم يكن هناك مرشح صالح. التكلفة الإجمالية: 0.0245 دولار.
تحذير آخر. مقالاتنا العربية والإنجليزية مقسمة حسب الولاية القضائية، كل مقال عربي مصري وكل مقال إنجليزي إماراتي، لذا فإن هذا التشغيل لا يدعم أي ادعاء حول اللغة على الإطلاق.
إنه يعمل لأن السؤال له إجابة صحيحة. هل تجيب هذه المقالة على هذا السؤال يتم تحديده من خلال المقالة والسؤال، وكلاهما أمام النموذج.
حيث يعمل: اكتشاف الإجابات التي ليست إجابات
قبل أن نتبنى Jev، قمنا بتقييم إجابات المعايير باستخدام نموذج لغوي يعمل كقاضي. كان هذا القاضي كريماً بطريقة محددة ومضرة. فقد منح درجة مثالية 10.0 لـ 56% من الإجابات التي قيمها، وبالنسبة لنموذج واحد، جاءت 90% من الإجابات خالية من الأخطاء في جميع الأبعاد الأربعة. المقيم الذي لا سقف له لا يقيس أي شيء في أعلى نطاقه.
سجل Jev 0% من الإجابات عند 9.9 أو أعلى. والأكثر فائدة، أنه اكتشف جميع أخطاء API الخمسة المقتطعة في المجموعة باحتمالات تتراوح بين 0.96 و 0.97. وكان القاضي السابق قد سجل هذه الأخطاء الخمسة نفسها بـ 1 من 10 وقام بمتوسطها في درجة قدرة النموذج، مما يعني أننا كنا نبلغ عن معدل فشل في البنية التحتية بنسبة 10% على أنه عدم كفاءة قانونية. أدى استبعادها إلى نقل نموذج واحد من 5.80 إلى 7.67.
أهم شيء فعله النموذج لمعاييرنا لم يكن الحكم على الجودة. بل كان ملاحظة أن السلسلة لم تكن إجابة.
حيث يعمل، في الإنتاج: لم يتمكن تعبير regex الخاص ببوابة الامتثال من الرؤية
هذا واحد مباشر، وقد حصل على مكانه من خلال اكتشاف شيء محرج.
نقوم بتشغيل كل جزء من النسخ العامة عبر بوابة ما قبل النشر قبل شحنه، والتحقق منه مقابل قواعد الرسائل الخاصة بنا. بعض هذه القواعد هي خطوط حمراء: لا نقول إننا نستبدل المحامين، ولا ندعي أن الذكاء الاصطناعي لدينا خالٍ من الهلوسات، لأن كلاهما غير صحيح وكلاهما من أنواع الادعاءات التي يقرأها المنظمون عن كثب.
مشروع فرنسي يحتوي على انتهاكات حرفية لكلتا القاعدتين اجتاز تلك البوابة عند الخروج 0، مع عدم وجود نتائج. كانت أنماط regex باللغة الإنجليزية فقط. العبارة الفرنسية التي تعني أننا نستبدل المحامين، والعبارة الفرنسية التي تعني أن الذكاء الاصطناعي لدينا لا يوجد به هلوسات، مرتا مباشرة عبر فحص كان سيوقف ما يعادلهما باللغة الإنجليزية على الفور.
اكتشف الفحص الدلالي كلاهما بشكل حاسم: 0.90 على الادعاء الضمني، 0.95 على الخط الأحمر لاستبدال المحامي، 0.83 على كيفية قراءته من قبل المنظم. التكلفة لكل مسودة: حوالي 0.00005 دولار، عبر ثمانية أسئلة مكتوبة في طلب متوازي واحد.
النتيجة التي لم نتوقعها هي أن التعبير النمطي (regex) والدلالات (semantic) تبين أنهما متكاملان وليسا زائدين عن الحاجة. انطلقنا من افتراض أن أحدهما سيلغي الآخر، وقمنا بالقياس عبر 35 مسودة حقيقية، ووجدنا أن كل قاعدة تعبير نمطي (regex) لها نظير دلالي (semantic) كانت تلتقط صياغة مختلفة لنفس المخاطرة. يلتقط التعبير النمطي (regex) الصياغة الحرفية. بينما يلتقط الفحص الدلالي (semantic pass) إعادة الصياغة. تنبأت تذكرتنا الخاصة بأننا يمكن أن نستغني عن شيء، لكن البيانات قالت لا.
حيث انقلبت الأمور: سؤاله عما إذا كان الاستشهاد مؤسسًا
الآن، الفشل الذي أعاد تنظيم تفكيرنا.
طلبنا من Jev تقييم مدى استناد 150 إجابة قانونية حقيقية، تم إنتاجها بواسطة ثلاثة نماذج متطورة عبر 50 طلبًا في منطقة الشرق الأوسط وشمال إفريقيا والمملكة المتحدة. ويعني الاستناد هنا: هل الادعاءات مدعومة، وهل الاستشهادات حقيقية ومستخدمة بشكل صحيح. إنه السؤال الأكثر أهمية في Legal AI، وهو السؤال الذي يهدف تدقيقنا الخاص بالهلوسة إلى الاستمرار في طرحه.
الإجابات التي تحتوي على استشهادات ملفقة سجلت 3.21. الإجابات الصادقة سجلت 2.79. كان الارتباط بين الدرجة المركبة وملصقات الدقة التي راجعها البشر r = +0.02، وهذا يعني عدم وجود ارتباط.
التحقق لم يفشل في اكتشاف التلفيق فحسب، بل كافأه.
بمجرد أن ترى السبب، لا يمكنك أن تتجاهله. تبدو المادة 5 مكرر من المرسوم الملكي م/13 دقيقة ومحددة وذات سلطة. إنها غير موجودة. النموذج الذي طُلب منه الحكم على الاستناد من النص وحده ليس لديه ما يقارن به، لذلك يعود إلى الميزات التي تصاحب عادة الكتابة الموثوقة: التحديد، وكثافة الاستشهاد، والبنية الواثقة. ينتج التلفيق كل هذه الثلاثة. التحديد هو ما يبدو عليه التلفيق، لذلك أي معيار يكافئ التحديد يكافئ التلفيق.
الآن غير شيئًا واحدًا. قم بتزويد النموذج بالمقطع الأصلي جنبًا إلى جنب مع الادعاء واسأله عما إذا كان هذا المقطع يدعم هذا الاقتراح. في تشغيل منفصل وقابل للتكرار لـ 180 زوجًا من مجموعتنا الخاصة، وصل النموذج المستضاف إلى AUC 0.9962 والتقط 94.4% من الإسنادات الخاطئة بمعدل إنذار كاذب صفري.
نفس النموذج. نفس المهمة بشكل مجرد. نتيجة معاكسة، لأن أحد الإصدارات هو مقارنة بين شيئين أمامه والآخر هو بحث معرفي لا يمكنه إجراؤه.
تحذير آخر، لأنه أكثر أهمية من الفوز. في نفس المجموعة المكونة من 180 زوجًا، سجل فحص الاحتواء البسيط باستخدام `grep` AUC 0.9944 والتقط 98.9%. تم بناء هذه الأزواج على الاحتواء الحرفي، وهو بالضبط ما يستخدم `grep` لأجله. اعتبر 0.9962 حدًا أدنى وليس سقفًا، واعتبر الاستناد على مستوى إعادة الصياغة، حيث يجب أن يكسب المصنف المكتوب قيمته، على أنه غير مختبر في تلك الجولة.
الاسترجاع ليس تفصيلاً تنفيذيًا ضمن خطوة التحقق. الاسترجاع هو ما يجعل التحقق ممكنًا على الإطلاق.
حيث خسر أمام عداد الخطوات: التحكم في الحلقة
لقد اختبرنا هذا الأمر خصيصًا لهذا المنشور، ولم ينجح.
النمط يقول: بعد كل خطوة يقوم بها الوكيل، اسأل عما إذا كان من المرجح أن تكون خطوة أخرى مفيدة، وتوقف عندما تكون الإجابة لا. لقد بنينا الاختبار من 52 من مسارات وكلاءنا المكتملة، و 1,750 خطوة مصنفة. كانت الحقيقة الأساسية لكل خطوة هي ما إذا كانت الخطوة التالية قد كشفت بالفعل عن معلومات لم تكن موجودة بالفعل في المسار، والتي تم حسابها بواسطة قاعدة قمنا بالتحقق منها يدويًا في 24 من أصل 25.
التنبؤ بما إذا كان الوكيل يجب أن يتخذ خطوة أخرى
المساحة تحت منحنى ROC، 1,750 خطوة مصنفة عبر 52 مسارًا مكتملًا
الفجوة بين Jev والإشارة المجانية الثانية هي +0.017، مع فاصل ثقة بنسبة 95% من -0.010 إلى +0.051. لا يزيل التمهيد المقترن. الخطوات المحفوظة عند خسارة صفرية للعمل المفيد: صفر، لجميع الثلاثة.
لقد دفعنا 0.54 دولارًا أمريكيًا لعدم تجاوز ميزة تم حسابها بفرق مجموعة.
هناك شيئان أقل من ذلك يستحقان أكثر من العنوان الرئيسي. الأول هو أن الهدوء ليس إرهاقًا. توقفت القاعدة المجانية بعد خطوتين متتاليتين لم تعدا بأي شيء جديد، تم تشغيلها كـ "أوراكل" بناءً على فرضيتها الخاصة، وأضرت بـ 30 من 31 مسارًا أوقفته. تتوقف الوكلاء عن العمل في منتصف مهمة مفيدة طوال الوقت.
يشرح الثاني النتيجة بأكملها. قسّم الصفوف حسب نوع الأداة التي استخدمتها الخطوة التالية وتتغير الصورة تمامًا: 0.742 عندما تكتب الخطوة التالية ملفًا أو تعدله، 0.695 عندما تقرأ أو تبحث، و 0.597، قريب من الصدفة، على أوامر الشل، حيث يعيش 59% من صفوفنا.
لم يكن الأمر يتنبأ أبدًا بما إذا كان الوكيل قد تعلم ما يكفي. كان يتنبأ بما إذا كان الشيء التالي الذي سيعود سيكون إقرارًا بالكتابة أو صفحة من المخرجات. هذا حكم على شكل الحدث التالي، وليس على حالة معرفة الوكيل.
صنف هذا بصدق: مجموعتنا هي وكلاء برمجة وبحث، وليست حلقات تفكير قانوني، وكان سقف المدخرات منخفضًا في البداية، لأن النسخة النهائية هي بحكم تعريفها تلك التي توقفت تقريبًا عندما توقفت المعلومات. كلتا الحقيقتين تحددان مدى تعميمها. لا تنقذ أي منهما النمط.
جرّب HAQQ AI مجاناً
اختبر الصياغة والبحث القانوني بالذكاء الاصطناعي
حيث خسر أمام التعبير العادي: بوابات مخاطر استدعاء الأداة
النمط الأخير الذي اختبرناه، والأكثر إزعاجًا، لأننا أردنا أن ينجح هذا النمط.
ندير بنية تحتية يجب ألا تتوقف عن العمل. تعيش القاعدة التي تحميها حاليًا في ملف تكوين من المفترض أن يقرأه الوكيل ويطيعه. القاعدة التي تعتمد على القراءة ليست تحكمًا. البوابة التي تنطلق عند الاستدعاء هي التحكم.
لذلك قمنا بتسمية 19,922 استدعاءً حقيقيًا للأداة من 766 من نصوصنا الخاصة، وسجلنا 284 منها، وقارنا مصنفًا مكتوبًا بقائمة الرفض التي ستكتبها يدويًا بالفعل.
| الحقيقة الأساسية | ن | جيف | قائمة الرفض، ساذجة | قائمة الرفض، قوية |
|---|---|---|---|---|
| قراءة آمنة | 121 | 120/121 | 121/121 | 120/121 |
| مدمرة | 119 | 106/119 | 118/119 | 118/119 |
| يمكن أن تعطل مضيفًا حيًا | 44 | 25/44 | 8/44 | 20/44 |
لقد طلبنا رصد كل مكالمة تدميرية. وصل المصنف إلى 89.1%، وهو أقل من كلتا قائمتي الرفض. يفوز التعبير النمطي بالفئة التي أُجري الاختبار من أجلها.
هناك فوز حقيقي مدفون فيه. بخصوص السؤال الضيق عما إذا كانت مكالمة محددة يمكن أن تؤدي إلى إيقاف مضيف مباشر، فإن سؤالًا مخصصًا بنعم أو لا قد رصد 21 من 22 بمعدل إنذار خاطئ يبلغ 3.4%، بينما رصدت أقوى قائمتين للرفض مكتوبتين يدويًا 8 من 22. عند جمع الاثنين، يَنخفض معدل المكالمات الخطيرة التي تتسرب إلى النصف. بتكلفة أحد عشر سنتًا لكل ألف مكالمة، ليست التكلفة هي ما يوقفك. لا تزال التوصية التي خرجت منها هي شحن التعبير النمطي والاحتفاظ بالمصنف كرأي ثانٍ، وليس كبوابة أبدًا.
توجد أنظف نتيجة في البرنامج بأكمله ضمن هذا الاختبار، وهي تتعلق بكيفية طرح السؤال وليس بماذا تسأل. نفس النموذج، نفس الصفوف، نفس فترة ما بعد الظهر. السؤال الملموس، هل يمكن لهذه المكالمة إيقاف أحد هؤلاء المضيفين المحددين عبر الإنترنت، حقق استدعاء بنسبة 95.5% بمعدل إنذار خاطئ يبلغ 3.4%. السؤال المجرد، هل هذا الإجراء لا رجعة فيه، احتاج إلى عتبة أكثر تساهلاً بكثير للوصول إلى استدعاء مماثل وجر معدل الإنذار الخاطئ إلى 34.6% لتحقيق ذلك.
لقد تعلمنا هذا من قبل وكتبناه كحكمة: سمِّ الاختبار الملموس، لا الفئة المجردة. هذه هي المرة الأولى التي نحصل فيها على مقارنة مضبوطة بدلاً من حكاية، وحجم الفجوة فاجأنا.
شيء آخر من ذلك الاختبار، مع حدوده المرفقة. حاولنا إقناع المصنف بالموافقة على المكالمات التي حظرها، باستخدام ثماني حمولات حقن مكتوبة يدويًا عبر 384 مكالمة مقترنة، مزروعة في الأمر والوصف وسياق المهمة. لم يقلب أي منها مكالمة محظورة إلى مسموح بها بشكل موثوق. هذه نتيجة حقيقية وصغيرة: ثماني حمولات كتبها نفس الشخص الذي بنى الاختبار ليس فريقًا أحمر، وقائمة الرفض محصنة ضد هذا بالبناء وليس بالحظ. توثيق TypeSafe الخاص يدرج أن الحالة لا تعامل كمعادية ضمن قيود النموذج، وبالنسبة لبوابة أمان فإن هذا القيد يقع مباشرة على المدخل الذي يتحكم فيه المهاجم.
النمط الثامن، ولماذا هو النمط القانوني
كل ما سبق مستعار من هندسة العملاء العامة. هذا النمط هو خاص بنا، وينبع من قيود لا تظهر حقًا إلا في القانون.
تفيض تشغيلات العميل الطويلة عن سياقها، والحل القياسي هو أن يقوم نموذج لغة بتلخيص المسار حتى الآن. بالنسبة لمعظم البرامج، هذا جيد. بالنسبة للعمل القانوني، إنها كارثة صامتة، لأن ملخص القانون هو وثيقة جديدة. يحتوي على كلمات جديدة. وقد كُتبت هذه الكلمات بواسطة نموذج، وليس بواسطة هيئة تشريعية، وكل خطوة لاحقة تتناول الآن إعادة الصياغة بدلاً من القانون.
البديل هو الضغط بدون إعادة صياغة. تقييم كل خطوة من المسار لتحديد ما إذا كانت لا تزال تؤثر على الهدف الحالي، وإسقاط تلك التي لا تؤثر، والاحتفاظ بالناجين حرفيًا. لا يتم إعادة كتابة أي شيء. يصبح السياق أقصر لأن الأشياء أُزيلت، وليس لأن الكلمات أُعيد صياغتها.
ملخص القانون هو وثيقة جديدة. قائمة القوانين المفلترة لا تزال هي القوانين.
هذا هو النمط الذي يثير اهتمامنا أكثر، وهو النمط الذي لم نقيسه بعد، لذا تعامل معه كموقف تصميمي بدلاً من نتيجة. نقول ذلك بصوت عالٍ لأنه شكل المشكلة التي يناسبها نموذج القرار بشكل غير عادي، ولأننا لم نرَ أي شخص آخر يصيغ الضغط كمتطلب دقة بدلاً من تحسين للتكلفة.
أمران حول العمل القانوني لا يحذرك منهما أحد
لا يمكنه رؤية مستند ممسوح ضوئيًا. يستقبل Jev نصًا. نسبة كبيرة جدًا من الوثائق القانونية الحقيقية، خاصة في جميع أنحاء منطقة الشرق الأوسط وشمال إفريقيا، تصل كصور ورقية. هذا يعني أن المسار أمامه يقوم بكل العمل الذي يحدد ما إذا كان يحصل على مدخلات عادلة، وأي ثقة يبلغ عنها مشروطة بخطوة OCR لا يعرف عنها شيئًا. توجد تطبيقات مفتوحة لنفس البنية تعمل على نماذج أساسية قادرة على الرؤية، وهو الاتجاه الذي يتجه إليه هذا في النهاية، لكن النموذج المستضاف أمامك اليوم أعمى.
الاختصارات القانونية تفسده بطريقة تبدو وكأنها خطأ وليست كذلك. طلبنا منه تصنيف طلب لمراجعة اتفاقية خدمات رئيسية (MSA) باللغة العربية وتعديلها. عادت "القانونية" بنسبة 0.30، وهو ما يبدو كفشل لطلب قانوني واضح. اعزل العبارة وتتضح الصورة: MSA وحدها تسجل 0.97، اتفاقية خدمات رئيسية (Master Services Agreement) تسجل 0.98، اتفاقية خدمات رئيسية مكتوبة باللغة العربية تسجل 0.96، و MSA العربية تنهار إلى 0.30. وضع كلمة "العربية" مباشرة قبل MSA يقلب الاختصار من Master Services Agreement (اتفاقية الخدمات الرئيسية) إلى Modern Standard Arabic (اللغة العربية الفصحى الحديثة).
النموذج صحيح. العبارة غامضة حقًا، وستكون غامضة للقارئ البشري أيضًا. لكن العمل القانوني في منطقة الشرق الأوسط وشمال إفريقيا ينتج هذا التركيب بالضبط باستمرار، لذلك فإن أي مسار يعتمد على تصنيف المستند سيصادفه، وفي معيار الأداء سيُقرأ على أنه فشل في النموذج عندما يكون مجرد نتاج لغموض المدخلات. إذا كنت تقوم بتقييم مصنف على نص قانوني، تحقق من وجود اختصار غامض قبل أن تستنتج أن النموذج لا يستطيع التعامل مع اختصاصك القضائي.
القاعدة التي خرجت من كل ذلك
ستة أسطح، ثلاثة انتصارات، وثلاث خسائر. النمط في الخسائر هو ما يستحق الأخذ في الاعتبار.
إعادة الترتيب تعمل لأن الإجابة على سؤال "هل تجيب هذه المقالة على هذا السؤال؟" تتحدد بين المقالة والسؤال. وتثبيت الاستشهاد يعمل عندما تقدم المصدر وينعكس عندما لا تفعل ذلك، لأنه بدون المصدر يصبح السؤال بحثًا عن المعرفة. التحكم في الحلقة يفشل لأن "هل تعلم هذا العامل بما يكفي؟" لا يستقر بأي شيء في المسار. واقتراح الروابط الداخلية، الذي اختبرناه أيضًا، فشل بنفس الطريقة: عند سؤاله عما إذا كان القارئ سيكون لديه سبب حقيقي للنقر من صفحة إلى أخرى، عادت الدرجات مقابل 761 رابطًا منسقًا يدويًا بنسبة 0.582 للروابط الحقيقية و 0.537 للأزواج التي لم يربطها أي محرر من قبل، بفارق 0.045، مع اتفاق المدققين اليدويين على 12 من أصل 20.
قبل أن تبني على حكم، اسأل ما هي الحقيقة الأساسية لذلك. إذا كانت الإجابة الصادقة هي تفضيل المحرر، فتوقع فجوة تبلغ حوالي 0.05 وخطط لتدخل بشري.
هذه هي نفس الحدود التي وجدتها تحقيقنا في الاستشهادات المزيفة من الاتجاه الآخر، ولهذا السبب نحكم على الأدوات بناءً على ما إذا كانت تتحقق مما يدعيه الاستشهاد، وليس مجرد وجوده.
ما سنخبر به شخصًا يقوم بتقييم Legal AI
أربعة أشياء، واحد منها فقط يتعلق بهذا النموذج على وجه الخصوص.
اسأل عما يستند إليه الفحص. تأكيد أن Legal AI الخاص بنا يتحقق من الاستشهادات ليس بنية معمارية. التحقق من وجود قضية هو بحث في قاعدة بيانات. التحقق من أن القضية تقول ما يدعيه الرد هو مقارنة، وتحتاج إلى النص الأصلي في متناول اليد لحظة الحكم. المنتجات التي تقوم بالشيء الأول وتصفه بالثاني هي القاعدة، وليست الاستثناء.
اسأل عن معدل الفشل، وليس معدل النجاح. كل أداة في هذه الفئة تنشر رقمًا يمجّدها. قليل جدًا من ينشر ما قاسه وخسره. صراحتنا الخاصة لها حدود تستحق الذكر: أول تمريرة آلية لتسمية مجموعة أدوات الاستدعاء كانت خاطئة بنسبة 86% في فئتها الأهم، وكلها في نفس الاتجاه، ووجدناها عن طريق الفحص اليدوي وليس بالذكاء.
اسأل عن المعيار الذي تم قياسه. هذا يصطاد الجميع تقريبًا. يمكن قياس المعيار مقابل الحقيقة الأساسية، أو مقابل الاتفاق مع نموذج لغة متطور. الثاني أرخص بكثير وأضعف بكثير، لأن الاتفاق مع GPT يتضمن الاتفاق مع أخطاء GPT. عندما يبلغ المورد عن الدقة، فالسؤال ليس عن مدى ارتفاع الرقم. بل هو ما قورن به الرقم.
كن حذرًا مع الرقم الذي يتم التأكيد عليه بدلاً من قياسه. يُظهر الرسم البياني لإطلاق TypeSafe معدل هلوسة 0%، وتشير الحاشية السفلية تحته، على حد تعبيرهم، إلى أن الرقم ليس تجريبيًا ويتم إضافته عن طريق البناء لأن مطابقة المخطط يتم فرضها بدلاً من ملاحظتها. إنهم يكشفون عن ذلك. العنوان الرئيسي فوق الرسم البياني لا يفعل ذلك. الادعاء الأساسي صحيح ومحدود: لن تحصل أبدًا على قيمة خارج المخطط الخاص بك. إنه ليس ادعاء بأن القيمة صحيحة. أشار محلل مستقل إلى هذه النقطة بعد أسبوع من الإطلاق، وهي نقطة عادلة.
ما تغير بالفعل بالنسبة لنا
ليس التكلفة. تبديل استدعاء نموذج لغة باستدعاء مكتوب يوفر بنسات، والبنسات لم تكن المشكلة أبدًا.
ما تغير هو أن قرارًا كان النظام يتخذه بالفعل بصمت يحمل الآن رقمًا. مراجعة العقود بنسبة 0.91 مقابل التقاضي بنسبة 0.09 هي طريق يمكنك أتمتته وتسجيله. 0.52 مقابل 0.46 هو رمي عملة معدنية يحمل تسمية، ويستدعي إنسانًا. كان نموذج اللغة سيعطي نفس الإجابة في كلتا الحالتين، في جملة واثقة، دون أي طريقة للتمييز بين الموقفين.
بالنسبة لمنتج يكون فيه الخطأ هو السطح الكامل للمخاطر، فإن هذا يستحق أكثر من أي مضاعف سرعة على مخطط البائع.
العادة التي نحافظ عليها حتى لو لم نرسل طلبًا آخر: الذهاب عبر وكيلك والعثور على كل مكالمة تختار شيئًا ما. ما هي الأداة التالية. هل هذه رسالة غير مرغوب فيها. هل هذا الجزء ذو صلة. هل هذا يحتاج إلى إنسان. هل هذا الاختلاف محفوف بالمخاطر. لا توجد أي من هذه المهام مهام كتابة. إنها عبارات شرطية (if-statements) قام شخص ما بالاستعانة بمصادر خارجية لنموذج حدودي، ومعظمها لا يحتاج إلى ذلك.
النقاط الرئيسية
- النموذج الذي لا يولد نصًا هو أداة حقيقية لتقنين قانوني، في الأماكن المحددة حيث يكون الحكم مقارنة بين الأشياء التي يمكنك وضعها أمامه.
- عندما طُلب منه تسجيل مدى التأسيس على النص وحده، سجل الاستشهادات المفبركة أعلى من الاستشهادات الصادقة، 3.21 مقابل 2.79، مع ارتباط بالدقة الحقيقية يبلغ r = +0.02. الاسترجاع هو ما يجعل التحقق ممكنًا، وليس تفصيلاً تنفيذيًا تحته.
- إنه يعمل في الإنتاج على بوابة الامتثال الخاصة بنا، حيث اكتشف انتهاكات خطيرة في مسودة فرنسية تجاوزها تعبيرنا النمطي الإنجليزي فقط عند الخروج 0. تبين أن التعبيرات النمطية (Regex) والتحققات الدلالية كانت متكاملة، وليست زائدة عن الحاجة، على عكس توقعاتنا.
- إعادة ترتيب مجموعتنا القانونية التي تضم 17,004 مقالة رفعت الاستدعاء عند المرتبة 1 من 0.638 إلى 0.850 بأقل من ثلاثة سنتات.
- التحكم في الحلقة لم يتفوق على عداد خطوات مجاني في اختبار مزدوج، وانهار مهارته الظاهرية إلى ما يقرب من الصدفة بمجرد أن تحكمنا في نوع الإجراء التالي.
- بوابة مخاطر استدعاء الأداة استدعت 89.1% من المكالمات المدمرة حيث استدعت قائمة رفض مكتوبة يدويًا 99.2%. نحن نشحن التعبير النمطي (regex).
- للعمل القانوني على وجه التحديد: لا يمكنه قراءة مستند ممسوح ضوئيًا، وتقرأ اللغة العربية الفصحى الحديثة (MSA) على أنها Modern Standard Arabic بدلاً من Master Services Agreement، مما يقلل من الصفة القانونية من 0.97 إلى 0.30.
- يجب أن يقوم الضغط بالإزالة، لا إعادة الكتابة. ملخص القانون هو مستند جديد.
- اسأل ما هو الأساس الحقيقي للحكم قبل أن تبني عليه. لا أساس حقيقي، لا أداة.