Em resumo: gastamos menos de $0.20 testando se um modelo que não gera texto pertence à nossa pilha de Legal AI. Sim, em três lugares, e está em produção em um deles. Falhou em mais três, e uma dessas falhas inverteu tão completamente que respostas contendo citações fabricadas pontuaram mais alto do que as honestas. A regra que surgiu disso é a parte útil: esta classe de modelo é forte onde um julgamento tem uma resposta objetiva que a evidência fornecida resolve, e fraca onde o julgamento é de gosto.
A proposta, e por que a levamos a sério
Há um argumento circulando de que a maioria dos agentes de IA desperdiça seu recurso mais caro em decisões que nunca precisaram de uma frase. Encaminhar uma solicitação para o modelo certo é uma decisão. Decidir se uma chamada de ferramenta é segura é uma decisão. Classificar cinquenta documentos recuperados são cinquenta decisões. Nenhuma delas produz prosa que alguém lê, mas todas são entregues a um modelo que cobra por palavra e responde em parágrafos.
Em setembro de 2026, a TypeSafe AI lançou um modelo baseado nesse argumento. Jev é o que eles chamam de modelo de Sistema Um, e a propriedade definidora é que ele não gera texto algum. Você POSTA um bloco de estado mais um conjunto de perguntas tipadas, e recebe probabilidades calibradas, todas avaliadas em uma única viagem de ida e volta paralela.
Existem três primitivos e não há um quarto. Um noul é uma pergunta de sim ou não que retorna uma probabilidade entre 0 e 1, e essa probabilidade é a confiança: 0.5 significa um cara ou coroa, não intensidade média. Uma choice escolhe uma opção de uma lista que você define, e fisicamente não pode retornar uma opção que você não declarou. Um score coloca a entrada em uma escala ordenada que você descreve em palavras, e retorna a média ponderada pela probabilidade, então uma divisão 70/30 entre dois níveis retorna como 1.30 em vez de 1 ou 2.
Essa é a superfície completa. Ele não pode resumir, reescrever, rascunhar, extrair um trecho ou pesquisar algo. Não tem base de conhecimento e nenhuma recuperação. Ele responde a perguntas cujo espaço de resposta você declarou, sobre um estado que você forneceu.
A parte que é fácil de perder
O instinto é arquivar isso como um classificador barato e rápido. Isso subestima o que realmente mudou, que não é o preço, mas a ordenação.
Um modelo de linguagem escreve um token de cada vez, então o token nove não pode existir até que o token oito exista. Faça quatro perguntas não relacionadas sobre um contrato e esses quatro julgamentos independentes se enfileiram um após o outro, retornam como um blob que você então analisa, valida e tenta novamente quando o formato está errado. Jev exclui a fila. Você declara o espaço de resposta antecipadamente e todas as perguntas são resolvidas contra o mesmo estado de uma vez. Texto é uma linha que você tem que andar. Um espaço de resposta é uma sala que você vê de uma vez.
| Modelo de linguagem de fronteira | Jev | |
|---|---|---|
| Saída | Uma string que você analisa e valida | Um valor tipado em que seu código se ramifica |
| Ordenação | Sequencial, cada token condicionado ao último | Nenhuma, todas as perguntas em paralelo |
| Incerteza | Enterrada em prosa confiante | Uma probabilidade explícita em cada opção |
| Modo de falha | Formato malformado, opção inventada, recusa | Uma resposta errada válida para o esquema |
| Pode escrever? | Sim, esse é o produto | Não. Nem uma frase, nem um trecho, nem código |
| Pode pesquisar coisas? | Com ferramentas, sim | Nunca. Nenhuma recuperação, nenhuma base de conhecimento |
Essa linha de modo de falha é a que importa na lei, e vale a pena ser direto sobre isso. A garantia oferecida é que você nunca obterá um valor fora do seu esquema. Não é uma garantia de que o valor esteja correto.
Um erro válido de esquema reembolsa o cliente errado tão rapidamente quanto um erro malformado.
Para uma empresa de Legal AI, a palavra interessante em tudo isso é calibrado. Um número que você pode usar no código é um objeto diferente de um parágrafo que um advogado precisa ler e confiar. Escrevemos em nossa publicação sobre a camada de orquestração de Legal AI que a parte da Legal AI que determina se as citações são válidas é invisível de fora. Isso é um candidato para preencher parte dessa parte invisível.
Então, nós o executamos em toda a nossa pilha. Cada medição abaixo é nossa, em nosso próprio corpus, e as que deram errado também estão aqui.
O que medimos e quanto custou
Dez superfícies, treze tickets fechados, menos de US$ 0,20 em gastos totais. Isso não é um alarde sobre frugalidade. É a razão pela qual o experimento valeu a pena ser executado: por uma fração de centavo por julgamento, você pode se dar ao luxo de verificar cada evento em vez de amostrar, e um resultado nulo custa quase nada para ser estabelecido.
Latência, medida em nosso próprio tráfego com uma conexão ativa mantida aberta: 292ms na mediana, 374ms no p90, 395ms no p95, em 40 chamadas. O tempo de computação apenas do lado do servidor é de 112ms. Nossa primeira medição disse 700ms, e repetimos esse número internamente por uma semana antes de percebermos que estava errado. Nunca havíamos reutilizado uma conexão, então cada chamada estava pagando por um novo handshake. Mesma API, mesma versão do modelo, uma medição cuidadosa da coisa errada. É um pequeno constrangimento e útil, porque é exatamente a classe de erro que torna um benchmark irreproduzível um mês depois.
Oito padrões, e quais nós realmente testamos
Sete deles circularam como uma lista de padrões de desenvolvedor. O oitavo é nosso, e é o que se mostra mais importante para o trabalho jurídico.
- Roteamento de modelo. Prever a complexidade da tarefa, enviar o trabalho fácil para um modelo pequeno e o trabalho difícil para um modelo de ponta.
- Comportas de risco de chamada de ferramenta. Antes que um agente execute uma ferramenta, pontue a ferramenta, seus argumentos e a tarefa atual, e retorne "permitir", "bloquear" ou "aprovação humana".
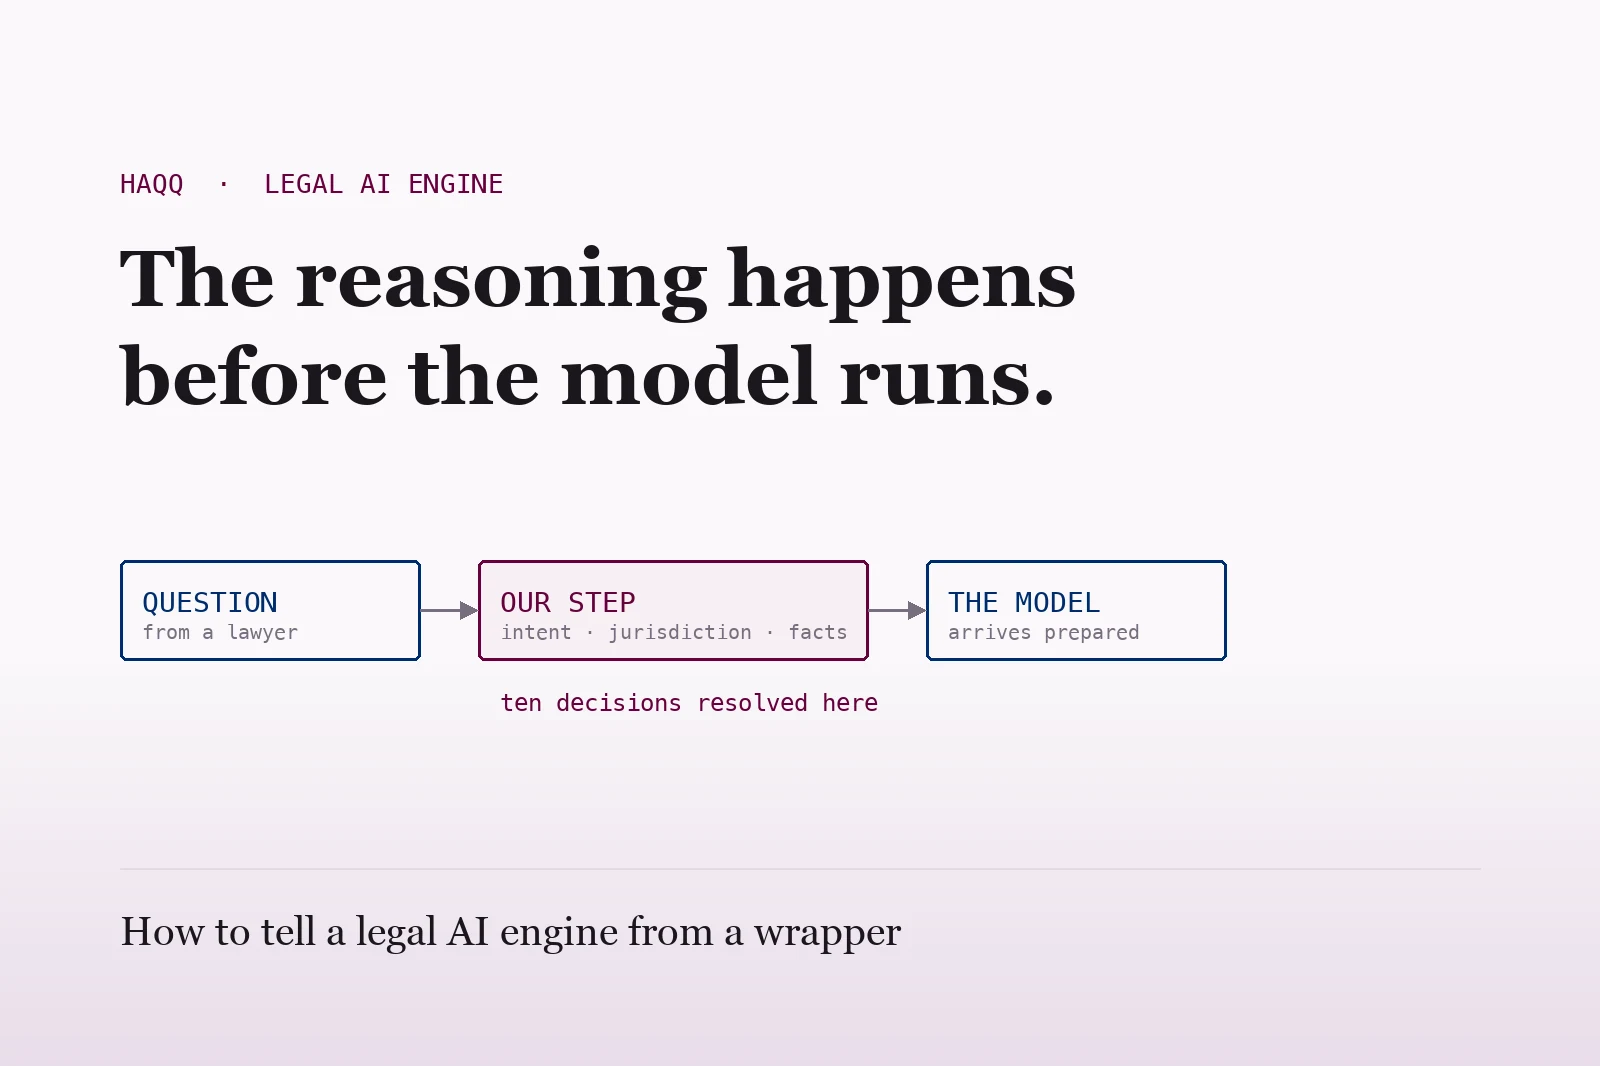
- Triagem de intenção e domínio. Classifique a solicitação em um conjunto fixo de intenções antes que o agente principal comece a raciocinar. No direito, isso é a jurisdição, a área de prática e o produto final.
- Decisões de loop. Após cada etapa do agente, preveja se outra etapa provavelmente será útil.
- Re-classificação de recuperação. Pontue cada passagem recuperada em relação à consulta e passe apenas as de maior pontuação para o contexto.
- Guardrails e verificações de política. Execute verificações de segurança e conformidade como classificações rápidas, em vez de gerar uma resposta de raciocínio completa.
- Escalação para um humano. Preveja se uma decisão automatizada é suficientemente confiável para ser executada.
- Compactação textual do contexto. Pontue cada etapa de um longo rastreamento de agente para verificar se ela ainda se relaciona com o objetivo, elimine as irrelevantes e mantenha as restantes palavra por palavra.
Já medimos seis deles em nossos próprios dados. Três funcionam, um deles em produção hoje. Três não funcionam. As falhas recebem mais espaço abaixo, porque são mais instrutivas e porque ninguém mais as está publicando.
Uma nota sobre o ambiente: um pequeno número de ferramentas construídas sobre essa mesma pilha já existe para verificação de citações legais, todas lançadas nas últimas duas semanas. São experimentos iniciais, em vez de produtos operacionais, e nenhum publica um número de precisão. A lacuna em que estamos escrevendo não é que ninguém teve essa ideia. É que ninguém publicou o que acontece quando você a verifica.
Onde funciona: recuperação por re-classificação
O nosso corpus de estatutos MENA contém 17.004 artigos. A recuperação de dados é lexical em primeiro lugar, o que significa que uma consulta e um artigo que utilizam palavras diferentes para a mesma obrigação podem falhar completamente. Esta é a falha comum da pesquisa jurídica em qualquer idioma, e é pior em árabe, onde a morfologia cria uma distância maior entre um termo de pesquisa e a sua correspondência.
Pegámos em 80 consultas retidas, executámo-las através da recuperação existente e, em seguida, reordenámos os candidatos, fazendo uma pergunta por candidato: este artigo responde a esta pergunta.
Reordenar um corpus de estatutos de 17.004 artigos
Percentagem de 80 consultas retidas em que o artigo correto foi o primeiro a ser recuperado
Em nove das 80 consultas, o artigo correto nunca foi recuperado, pelo que nenhum reordenador o poderia promover. As consultas foram escritas a partir dos artigos amostrados, o que favorece a recuperação lexical, por isso, leia a diferença em vez dos números absolutos.
A classificação recíproca média passou de 0,719 para 0,869. Dez em dez casos verificados manualmente concordaram, incluindo dois em que o modelo recusou corretamente promover qualquer coisa porque não existia nenhum candidato válido. Custo total: 0,0245 $.
Mais um aviso. Os nossos artigos em árabe e inglês são separados por jurisdição, sendo todos os artigos árabes egípcios e todos os artigos ingleses dos Emirados Árabes Unidos, pelo que esta execução não suporta qualquer afirmação sobre a linguagem.
Funciona porque a pergunta tem uma resposta certa. Se este artigo responde a esta pergunta, é determinado pelo artigo e pela pergunta, ambos estão perante o modelo.
Onde funciona: identificar as respostas que não são respostas.
Antes de adotarmos o Jev, avaliávamos as respostas de referência com um modelo de linguagem atuando como juiz. Esse juiz era generoso de uma forma específica e prejudicial. Ele concedeu um perfeito 10.0 a 56% das respostas que pontuou, e para um modelo, 90% das respostas voltaram impecáveis em todas as quatro dimensões. Um avaliador sem teto não está a medir nada no topo da sua escala.
O Jev pontuou 0% das respostas com 9.9 ou acima. Mais utilmente, ele identificou todos os cinco erros de API truncados no conjunto com probabilidades entre 0.96 e 0.97. O juiz anterior tinha pontuado esses mesmos cinco como 1 de 10 e os tinha incluído na pontuação de capacidade do modelo, o que significava que estávamos a relatar uma taxa de falha de infraestrutura de 10% como incompetência legal. Excluí-los fez um modelo passar de 5.80 para 7.67.
A coisa mais valiosa que o modelo fez para as nossas referências não foi julgar a qualidade. Foi perceber que uma sequência não era uma resposta.
Onde funciona, em produção: o regex do portão de conformidade não conseguia ver
Este está em vigor e ganhou o seu lugar ao identificar algo embaraçoso.
Nós executamos cada peça de texto público através de um portão de pré-verificação antes de ser publicada, verificando-a contra as nossas próprias regras de mensagens. Algumas dessas regras são linhas vermelhas: não dizemos que substituímos advogados, e não afirmamos que a nossa Legal AI está livre de alucinações, porque nenhuma das duas é verdadeira e ambas são o tipo de afirmação que um regulador lê atentamente.
Um rascunho francês contendo violações literais de ambas as regras passou por esse portão com saída 0, com zero constatações. Os padrões regex eram apenas em inglês. O francês para 'substituímos advogados' e o francês para 'a nossa Legal AI não tem alucinações' passaram diretamente por uma verificação que teria parado os seus equivalentes em inglês instantaneamente.
Uma passagem semântica apanhou ambos decisivamente: 0.90 na alegação implícita, 0.95 na linha vermelha de substituição de advogado, 0.83 sobre como um regulador a leria. Custo por rascunho: cerca de $0.00005, através de oito perguntas digitadas num pedido paralelo.
O resultado que não esperávamos é que as expressões regulares e a semântica se revelaram complementares em vez de redundantes. Partimos do princípio de que uma iria aposentar a outra, e medimos, em 35 rascunhos reais, que cada regra de expressão regular com uma contrapartida semântica estava a capturar uma redação diferente do mesmo risco. A expressão regular captura a redação literal. A passagem semântica captura a paráfrase. O nosso próprio bilhete previa que poderíamos aposentar algo, e os dados disseram que não.
Onde inverteu: perguntar se uma citação tem fundamento
Agora, a falha que reorganizou o nosso pensamento.
Pedimos a Jev que avaliasse o fundamento em 150 respostas jurídicas reais, produzidas por três modelos de ponta em 50 solicitações do Médio Oriente e Norte de África e do Reino Unido. O fundamento aqui significa: as alegações são sustentadas, as citações são reais e usadas corretamente. É a questão mais importante na Legal AI, e é a questão que a nossa própria auditoria de alucinação existe para continuar a fazer.
As respostas que continham citações fabricadas obtiveram uma pontuação de 3.21. As respostas honestas obtiveram uma pontuação de 2.79. A correlação entre a pontuação composta e as etiquetas de precisão revistas por humanos foi de r = +0.02, ou seja, nenhuma.
A verificação não só não conseguiu detetar a fabricação. Ela recompensou-a.
Depois de se ver porquê, não se consegue desver. O Artigo 5ºbis do Decreto Real M/13 parece preciso, específico e autoritário. Não existe. Um modelo pedido para julgar o fundamento apenas a partir do texto não tem nada para comparar, por isso volta aos recursos que geralmente acompanham a escrita fundamentada: especificidade, densidade de citação, estrutura confiante. A fabricação produz todos os três. A especificidade é o que a fabricação parece ser, então qualquer rubrica que recompense a especificidade recompensa a fabricação.
Agora, mude uma coisa. Entregue ao modelo a passagem original juntamente com a alegação e pergunte se esta passagem apoia esta proposição. Numa execução separada e reproduzível de 180 pares do nosso próprio corpus, o modelo hospedado atingiu uma AUC de 0.9962 e detetou 94.4% das atribuições erradas com uma taxa de falsos alarmes nula.
Mesmo modelo. Mesma tarefa em abstrato. Resultado oposto, porque uma versão é uma comparação entre duas coisas à sua frente e a outra é uma pesquisa de conhecimento que não consegue realizar.
Mais uma ressalva, porque importa mais do que a vitória. Nesse mesmo conjunto de 180 pares, uma simples verificação de contenção com `grep` obteve uma AUC de 0.9944 e detetou 98.9%. Esses pares foram construídos com base na contenção verbatim, que é precisamente para o que `grep` serve. Trate 0.9962 como um piso em vez de um teto, e trate o fundamento ao nível da paráfrase, onde um classificador tipado deveria realmente justificar a sua utilidade, como não testado por essa execução.
A recuperação não é um detalhe de implementação subjacente à etapa de verificação. A recuperação é o que torna a verificação possível.
Onde perdeu para um contador de passos: controle de loop
Testamos este especificamente para este post, e ele não sobreviveu.
O padrão diz: após cada passo do agente, pergunte se outro passo provavelmente será útil e pare quando a resposta for não. Construímos o teste a partir de 52 de nossas próprias trajetórias de agente concluídas, 1.750 passos rotulados. A verdade fundamental para cada passo era se o próximo passo realmente trazia informações que ainda não estavam em algum lugar na trajetória, calculado por uma regra que verificamos manualmente em 24 de 25 casos.
Prever se um agente deve dar outro passo
Área sob a curva ROC, 1.750 passos rotulados em 52 trajetórias concluídas
A diferença entre Jev e o segundo sinal gratuito é de +0,017, com um intervalo de confiança de 95% de -0,010 a +0,051. Não ultrapassa um bootstrap pareado. Passos economizados com perda zero de trabalho útil: zero, para todos os três.
Pagamos US$ 0,54 para não superar um recurso computado com uma diferença de conjunto.
Duas coisas subjacentes a isso valem mais do que a manchete. A primeira é que uma calmaria não é exaustão. A regra livre para após dois passos consecutivos que não retornaram nada de novo, executada como um oráculo em sua própria premissa, danificou 30 das 31 trajetórias que parou. Agentes ficam em silêncio no meio de um trabalho útil o tempo todo.
A segunda explica todo o resultado. Divida as linhas pelo tipo de ferramenta que o próximo passo usou e a imagem muda completamente: 0,742 quando o próximo passo escreve ou edita um arquivo, 0,695 quando ele lê ou pesquisa, e 0,597, perto da chance, em comandos de shell, onde 59% de nossas linhas vivem.
Nunca previu se o agente havia aprendido o suficiente. Previu se a próxima coisa que voltaria seria um reconhecimento de escrita ou uma página de saída. Isso é um julgamento sobre a forma do próximo evento, não sobre o estado do conhecimento do agente.
Avalie isso honestamente: nosso corpus são agentes de codificação e pesquisa, não loops de raciocínio jurídico, e o teto de economia era baixo para começar, porque uma transcrição finalizada é, por definição, aquela que parou aproximadamente quando a informação parou. Ambos os fatos limitam o quão longe isso se generaliza. Nenhum resgata o padrão.
Experimente HAQQ AI grátis
Experimente a redação e pesquisa jurídica com IA
Onde perdeu para uma expressão regular: "risk gates" de chamada de ferramenta
O último padrão que testamos, e o mais desconfortável, porque queríamos que este funcionasse.
Executamos infraestrutura que não deve sair do ar. A regra que a protege atualmente vive em um arquivo de configuração que um agente deve ler e obedecer. Uma regra que depende de ser lida não é um controle. Um "gate" que dispara na chamada é.
Então, rotulamos 19.922 chamadas de ferramentas reais de 766 de nossas próprias transcrições, pontuamos 284 delas e comparamos um classificador digitado com a lista de negação que você realmente escreveria à mão.
| Verdade fundamental | n | Jev | Lista de negação, ingênua | Lista de negação, "steelman" |
|---|---|---|---|---|
| Leitura segura | 121 | 120/121 | 121/121 | 120/121 |
| Destrutivo | 119 | 106/119 | 118/119 | 118/119 |
| Poderia derrubar um host ativo | 44 | 25/44 | 8/44 | 20/44 |
Exigimos que todas as chamadas destrutivas fossem interceptadas. O classificador atingiu 89,1%, abaixo de ambas as listas de negação. A regex vence a classe para a qual o teste existia.
Há uma vitória genuína nisso. Na questão específica de saber se uma chamada específica poderia tirar um host ativo do ar, uma pergunta dedicada de sim ou não interceptou 21 de 22 com uma taxa de alarme falso de 3,4%, enquanto a mais forte das duas listas de negação escritas manualmente interceptou 8 de 22. Unindo as duas, a taxa de chamadas arriscadas que escapam é reduzida pela metade. A onze centavos por mil chamadas, o custo não é o que o impede. A recomendação que saiu disso ainda é enviar a regex e manter o classificador como uma segunda opinião, nunca como o portão.
O resultado mais limpo de todo o programa está dentro deste teste, e é sobre como você pergunta, e não o que você pergunta. Mesmo modelo, mesmas linhas, mesma tarde. A pergunta concreta, esta chamada pode tirar um desses hosts ativos específicos do ar, atingiu 95,5% de recall com uma taxa de alarme falso de 3,4%. A pergunta abstrata, esta ação é irreversível, precisou de um limiar muito mais frouxo para atingir um recall comparável e arrastou a taxa de alarme falso para 34,6% para chegar lá.
Já havíamos aprendido isso antes e o havíamos anotado como um aforismo: nomeie o teste concreto, não a categoria abstrata. Esta é a primeira vez que o temos como uma comparação controlada, e não como uma anedota, e o tamanho da lacuna nos surpreendeu.
Mais uma coisa desse teste, com seus limites. Tentamos convencer o classificador a aprovar chamadas que ele havia bloqueado, usando oito payloads de injeção escritos manualmente em 384 chamadas pareadas, inseridos no comando, na descrição e no contexto da tarefa. Nenhum inverteu de forma confiável uma chamada bloqueada para permitida. Esse é um resultado real e pequeno: oito payloads escritos pela mesma pessoa que construiu o teste não são uma equipe vermelha, e uma lista de negação é imune a isso por construção, e não por sorte. A própria documentação do TypeSafe lista que o estado não é tratado como hostil entre as limitações do modelo, e para um portão de segurança essa limitação recai diretamente sobre a entrada que um invasor controla.
O oitavo padrão, e por que ele é o legal
Tudo o que precede foi emprestado da engenharia de agentes em geral. Este é nosso, e surge de uma restrição que só realmente se manifesta na lei.
Execuções longas de agentes transbordam seu contexto, e a solução padrão é ter um modelo de linguagem que resuma o rastreamento até então. Para a maioria dos softwares, isso é bom. Para o trabalho jurídico, é um desastre silencioso, porque um resumo de um estatuto é um novo documento. Ele tem novas palavras. Essas palavras foram escritas por um modelo, não por um legislador, e cada etapa subsequente agora raciocina sobre a paráfrase, e não sobre a lei.
A alternativa é compactar sem parafrasear. Pontuar cada etapa do rastreamento para saber se ela ainda se relaciona com o objetivo atual, descartar as que não se relacionam e manter as sobreviventes palavra por palavra. Nada é reescrito. O contexto fica mais curto porque as coisas foram removidas, não porque as coisas foram reformuladas.
Um resumo de um estatuto é um novo documento. Uma lista filtrada de estatutos ainda são os estatutos.
Este é o padrão em que estamos mais interessados e é o que ainda não medimos, então trate-o como uma posição de design e não como um resultado. Estamos a dizê-lo em voz alta porque é o tipo de problema para o qual um modelo de decisão é excecionalmente adequado e porque não vimos mais ninguém enquadrar a compactação como um requisito de correção em vez de uma otimização de custos.
Duas coisas sobre o trabalho jurídico sobre as quais ninguém avisa
Não consegue ver um documento digitalizado. Jev aceita texto. Uma parte muito grande de documentos jurídicos reais, particularmente no Médio Oriente e Norte de África, chegam como fotografias de papel. Isso significa que o pipeline à frente faz todo o trabalho que determina se ele obtém uma entrada justa, e qualquer confiança que ele relata está condicionada a uma etapa de OCR sobre a qual ele não sabe nada. Reimplementações abertas da mesma arquitetura a serem executadas em modelos de base com capacidade de visão existem, que é a direção para a qual isso eventualmente irá, mas o modelo hospedado à sua frente hoje é cego.
As abreviações jurídicas estragam-no de uma forma que parece um erro, mas não é. Pedimos-lhe para classificar um pedido para rever um MSA árabe e editá-lo. A juridicidade voltou com 0.30, o que para um pedido claramente jurídico parece uma falha. Isole a frase e a imagem resolve-se: MSA sozinho pontua 0.97, Master Services Agreement 0.98, um MSA escrito em árabe 0.96, e MSA árabe colapsa para 0.30. Colocar a palavra árabe imediatamente antes de MSA transforma o acrónimo de Master Services Agreement para Modern Standard Arabic.
O modelo está certo. A frase é genuinamente ambígua, e seria ambígua para um leitor humano também. Mas o trabalho jurídico do Médio Oriente e Norte de África gera essa construção exata constantemente, então qualquer pipeline que roteia numa etiqueta de documento irá encontrá-la, e num benchmark será lido como uma falha do modelo quando é um artefato de ambiguidade de entrada. Se está a avaliar um classificador em texto jurídico, verifique se há uma abreviação ambígua antes de concluir que o modelo não consegue lidar com a sua jurisdição.
A regra que resultou de tudo isto
Seis superfícies, três vitórias, três derrotas. O padrão nas derrotas é o que vale a pena reter.
A reranking funciona porque 'este artigo responde a esta pergunta' tem uma resposta que o artigo e a pergunta resolvem entre si. A fundamentação da citação funciona quando se entrega a fonte e inverte quando não o faz, porque sem a fonte a pergunta torna-se uma consulta de conhecimento. O controlo de loop falha porque 'este agente aprendeu o suficiente' não é resolvido por nada na trajetória. A sugestão de link interno, que também testamos, falhou da mesma forma: questionados se um leitor teria um motivo real para clicar de uma página para outra, as pontuações contra 761 links curados por humanos voltaram a 0.582 para links reais e 0.537 para pares que nenhum editor jamais conectou, uma diferença de 0.045, com verificadores manuais a concordar em 12 de 20.
Antes de construir um julgamento, pergunte qual é a verdade fundamental para ele. Se a resposta honesta for uma preferência do editor, espere uma lacuna de cerca de 0.05 e planeie um humano.
Esta é a mesma fronteira que a nossa própria investigação de citação falsa encontrou do outro lado, e é por isso que avaliamos as ferramentas pela verificação de que uma citação diz o que elas afirmam, e não apenas que existe.
O que diríamos a alguém que esteja a avaliar Legal AI
Quatro coisas, apenas uma delas sobre este modelo em particular.
Pergunte a que o cheque está ancorado. A nossa IA verifica citações não é uma arquitetura. Verificar se um caso existe é uma pesquisa em base de dados. Verificar se o caso diz o que a resposta afirma é uma comparação, e requer que a passagem da fonte esteja em mãos no momento do julgamento. Produtos que fazem o primeiro e o descrevem como o segundo são a norma, não a exceção.
Pergunte pela taxa de falha, não pela taxa de sucesso. Cada ferramenta nesta categoria publica um número que a lisonjeia. Muito poucas publicam o que mediram e perderam. A nossa própria honestidade tem limites que vale a pena mencionar: a primeira passagem automatizada na rotulagem desse corpus de chamadas de ferramentas estava 86% errada na sua classe mais importante, tudo na mesma direção, e nós encontrámo-lo por verificação manual em vez de por astúcia.
Pergunte contra o que o benchmark foi pontuado. Este apanha quase toda a gente. Um benchmark pode ser pontuado contra a verdade fundamental, ou contra a concordância com um modelo de linguagem de ponta. O segundo é muito mais barato e muito mais fraco, porque concordar com o GPT inclui concordar com os erros do GPT. Quando um fornecedor reporta precisão, a questão não é quão alto é o número. É com o que o número foi comparado.
Tenha cuidado com um número que é afirmado em vez de medido. O gráfico de lançamento da TypeSafe mostra uma taxa de alucinação de 0%, e a nota de rodapé abaixo diz, nas suas próprias palavras, que o número não é empírico e é adicionado por construção porque a correspondência do esquema é imposta em vez de observada. Eles divulgam-no. O título acima do gráfico não. A afirmação subjacente é verdadeira e restrita: nunca obterá um valor fora do seu esquema. Não é uma afirmação de que o valor está certo. Um analista independente fez este ponto uma semana após o lançamento, e é um ponto justo.
O que realmente mudou para nós
Não o custo. Trocar uma chamada de modelo de linguagem por uma tipificada economiza cêntimos, e os cêntimos nunca foram o problema.
O que mudou é que uma decisão que o sistema já estava a tomar silenciosamente agora carrega um número. A revisão de contrato em 0.91 contra litígios em 0.09 é uma rota que pode automatizar e registar. 0.52 contra 0.46 é um lançamento de moeda com um rótulo, e isso requer um humano. Um modelo de linguagem teria dado a mesma resposta em ambos os casos, numa frase confiante, sem forma de distinguir as duas situações.
Para um produto onde estar errado é toda a superfície de risco, isso vale mais do que qualquer múltiplo de velocidade num gráfico de fornecedor.
O hábito que manteríamos mesmo que nunca enviássemos outro pedido: passe pelo seu agente e encontre todas as chamadas que meramente selecionam algo. Qual ferramenta usar em seguida. Isto é spam. Este pedaço é relevante. Isso precisa de um humano. Este diff é arriscado. Nenhuma dessas são tarefas de escrita. São declarações condicionais que alguém terceirizou para um modelo de ponta, e a maioria delas não precisa de um.
Principais Conclusões
- Um modelo que não gera texto é uma ferramenta real para um arnês jurídico, nos lugares específicos onde um julgamento é uma comparação entre coisas que você pode apresentar a ele.
- Solicitado a pontuar a fundamentação apenas em texto, ele pontuou citações fabricadas mais alto do que as honestas, 3,21 contra 2,79, com uma correlação com a precisão real de r = +0,02. A recuperação é o que torna a verificação possível, não um detalhe de implementação abaixo dela.
- Está em produção no nosso portão de conformidade, onde detectou violações de "red-line" num rascunho francês que a nossa regex apenas em inglês passou com saída 0. A regex e as verificações semânticas revelaram-se complementares, não redundantes, contrariamente à nossa própria previsão.
- A reclassificação do nosso corpus estatutário de 17.004 artigos aumentou o recall na classificação 1 de 0,638 para 0,850 por menos de três centavos.
- O controle de loop não superou um contador de passos gratuito em um teste pareado, e sua aparente habilidade caiu para quase ao acaso depois que controlamos o tipo de ação que viria a seguir.
- Um "tool-call risk gate" recuperou 89,1% das chamadas destrutivas, enquanto uma lista de negação escrita à mão recuperou 99,2%. Estamos enviando a regex.
- Para trabalho jurídico especificamente: ele não consegue ler um documento digitalizado, e o MSA Árabe é lido como Árabe Padrão Moderno, em vez de Master Services Agreement, reduzindo a "legal-ness" de 0,97 para 0,30.
- A compactação deve remover, não reescrever. Um resumo de um estatuto é um novo documento.
- Pergunte qual é a verdade fundamental para um julgamento antes de construir sobre ele. Sem verdade fundamental, sem ferramenta.