Kurz gesagt: Ein echter Rechtsfall ist nicht ein Prompt und eine Antwort. Er verlangt, lange Dokumente zu lesen, über mehrere Rechtsordnungen hinweg zu argumentieren, mehrstufige Aufgaben abzuschließen, Quellen zu zitieren, die es gibt, und zu wissen, wann man sich enthält. Ein Test mit einem einzigen Prompt misst davon nur einen dünnen Ausschnitt. Dieser Beitrag beschreibt, was eine Rechts-KI leisten muss und wie HAQQ ihre Bewertung angeht. Er enthält keine Werte.
Ein Mandat ist kein Prompt
HAQQ AI kostenlos testen
Erleben Sie KI-gestützte juristische Recherche und Entwurf
Fragen Sie eine Juristin, was ein Mandat schwierig macht, und sie nennt selten die Frage. Sie nennt die Akte: einen Stapel Dokumente, drei verschiedene Daten, zwei anwendbare Rechte, eine Gegenseite, die mittendrin ihre Haltung geändert hat, und einen Partner, der bis Tagesende eine belastbare Antwort braucht. Die Schwierigkeit liegt in der Arbeit rund um die Frage.
Fünf Dinge kehren wieder. Jedes ist eine Stelle, an der eine Rechts-KI flüssig klingen und trotzdem scheitern kann.
Lange Dokumente
Ein Datenraum, ein Vertragspaket oder eine Gerichtsakte ist weit länger als das, was ein Mensch in einer Sitzung liest. Das Risiko ist nicht, dass das Modell sie überspringt. Das Risiko ist, dass es alles liest und den falschen Teil gewichtet: eine Change-of-Control-Klausel in einer Anlage, eine Ausnahme in einer Definition, eine Änderung, die einen früheren Punkt stillschweigend überschreibt. Eine Zusammenfassung, die sich gut liest, kann trotzdem die eine Klausel verfehlen, von der der Mandant später ungern erfahren würde.
Argumentation über Rechtsordnungen hinweg
Recht lässt sich nicht sauber übertragen. Ein Finanzierungsinstrument nach US-Muster, das in Vorzugsaktien wandelt, setzt einen Mechanismus für Aktiengattungen voraus, den eine libanesische Gesellschaft mit beschränkter Haftung nicht hat. Die Lehre der Consideration, im Common Law zentral, spielt im saudischen Vertragsrecht keine solche Rolle. Eine Beschäftigung nach Belieben gibt es in den Golfstaaten nicht; dort gelten Kündigungsfristen und Abfindungsansprüche am Ende des Dienstverhältnisses. Eine Antwort, die das falsche System anwendet, ist nicht leicht daneben. Sie ruht auf einer Regel, die nicht gilt.
Das System muss also wissen, welches Recht gilt, das sagen und die Regeln dieses Rechts von denen trennen, die es am besten kennt.
Mehrstufige Aufgaben
Eine Due Diligence, eine Vertragsprüfung gegen ein Playbook, ein Recherchevermerk mit Belegen: Das sind Abfolgen. Dokumente finden, Fakten extrahieren, am Recht prüfen, Widersprüche auflösen, entwerfen, kontrollieren. In unserem eigenen Experiment mit einem Datenraum lieferten dasselbe Modell, dieselben Dokumente und dieselbe Bewertung unterschiedliche Ergebnisse, je nachdem, wie die Arbeit aufgebaut war, nicht je nachdem, welches Modell lief. Wir haben das beschrieben in ein einzelner Prompt gegen einen Agentenschwarm bei der M&A-Due-Diligence.
Zitiergenauigkeit
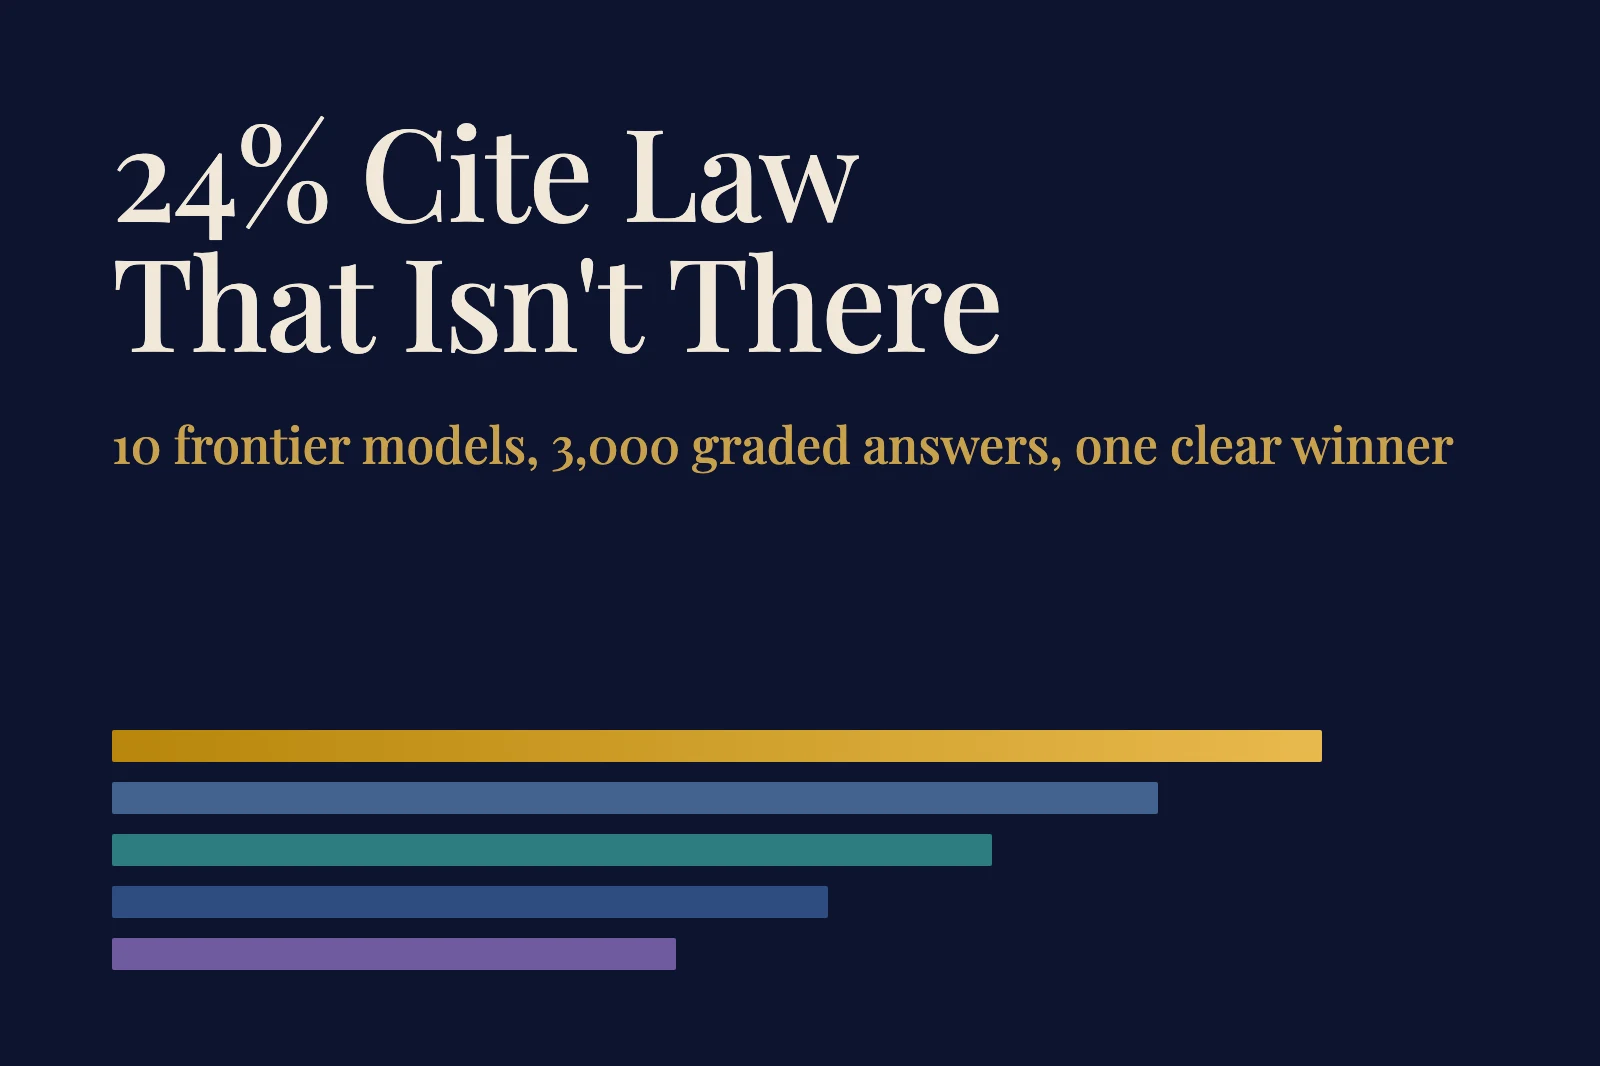
Eine flüssige Antwort mit einem Zitat, das es nicht gibt, ist der Fehler, den Gerichte sanktioniert haben. Die subtilere Variante ist eine echte Passage, die beim falschen Artikel zitiert wird, weil sie echt wirkt und eine flüchtige Prüfung übersteht. Manche Gerichte benennen die Pflicht inzwischen klar. Die Practice Direction No. 1 von 2026 des QICDRC in Katar verlangt etwa, jedes Zitat an Primärquellen oder einer anerkannten Rechtsdatenbank zu prüfen (Absatz 16). Wir haben sie behandelt in was die Practice Direction Katars tatsächlich verlangt.
Die Pflicht zur Überprüfung ändert sich nicht mit den Offenlegungsregeln. Eine Rechts-KI muss die Prüfung deshalb leicht durchführbar und leicht nachweisbar machen.
Kalibrierte Enthaltung
Manchmal ist die richtige Ausgabe keine Antwort. Die Quelle fehlt, das erfragte Recht gilt nicht, oder die Frage braucht Fakten, die niemand geliefert hat. Ein System, das immer antwortet, wird manchmal erfinden. Ein System, das immer verweigert, ist nutzlos. Kalibrierung heißt, sich zu enthalten, wenn die Grundlage fehlt, und zu antworten, wenn sie da ist. Sie ist von den fünf am schwersten zu testen, weil eine Enthaltung auf einer einfachen Wertungstafel wie ein Fehler aussieht.
Warum Ein-Prompt-Benchmarks das übersehen
- Sie liefern den relevanten Text mit. Echte Arbeit beginnt damit, ihn zu finden.
- Sie bewerten eine einzelne Antwort. Echte Arbeit ist eine Abfolge, in der sich ein früher Fehler fortsetzt.
- Sie belohnen das Antworten. Ein Modell, das sich nie enthält, kann gut abschneiden und trotzdem unsicher sein.
- Sie mitteln. Ein erfundenes Zitat unter fünfzig richtigen ist etwas anderes als einundfünfzig plausible Antworten, und ein Mittelwert verbirgt das.
- Sie sind meist für ein einziges Rechtssystem geschrieben und können deshalb nicht zeigen, dass ein Modell das falsche angewandt hat.
Wie HAQQ die Bewertung angeht
Wir behandeln diese Punkte als getrennte Dimensionen und berichten sie getrennt, statt sie in eine einzige Zahl zu verschmelzen. Wo eine Aufgabe durch exakten Vergleich geprüft werden kann, etwa Rechtsakt, Artikel oder ein Urteil echt oder erfunden, ist die Bewertung deterministisch und nutzt kein Modell als Richter. Wo die Antwort offen ist, liest ein Mensch sie. Musterlösungen werden aus Primärquellen aufgebaut und von einem Juristen geprüft, und manche Mandate enthalten eingepflanzte Probleme, damit wir wissen, was eine gute Antwort erkennen muss.
Wir nehmen außerdem Fragen auf, die abgelehnt werden sollen, und Fragen in einer Rechtsordnung, die das System zum Recht einer anderen verleiten. Umfang und Methode unserer MENA-Arbeit stehen in der MENA-Benchmark für Rechts-KI: Umfang und Methode.
Wichtigste Punkte
- Schwierige Rechtsarbeit steckt in der Akte rund um die Frage: lange Dokumente, mehrere Rechte, viele Schritte.
- Zitiergenauigkeit und kalibrierte Enthaltung sind getrennte Fähigkeiten, und keine zeigt sich in einem einzigen gemittelten Wert.
- Eine nützliche Evaluierung berichtet die Dimensionen getrennt und benennt, wo sie noch nicht urteilen kann.